안녕하세요, 버킷플레이스 DBRE(Database Reliability Engineering)팀의 Hank와 Sooya입니다. 저희 팀은 오늘의집 서비스를 지탱하는 데이터베이스를 책임지고 있습니다. 스키마 변경이나 장애 대응 같은 DBA 본연의 업무는 물론, 사람이 반복하던 일을 도구로 만들어 자동화하고, 서비스가 커져도 데이터베이스가 버틸 수 있도록 안정성과 확장성, 성능을 함께 고민하고 있습니다.
"이 테이블에 컬럼 하나만 추가해 주실 수 있을까요?"
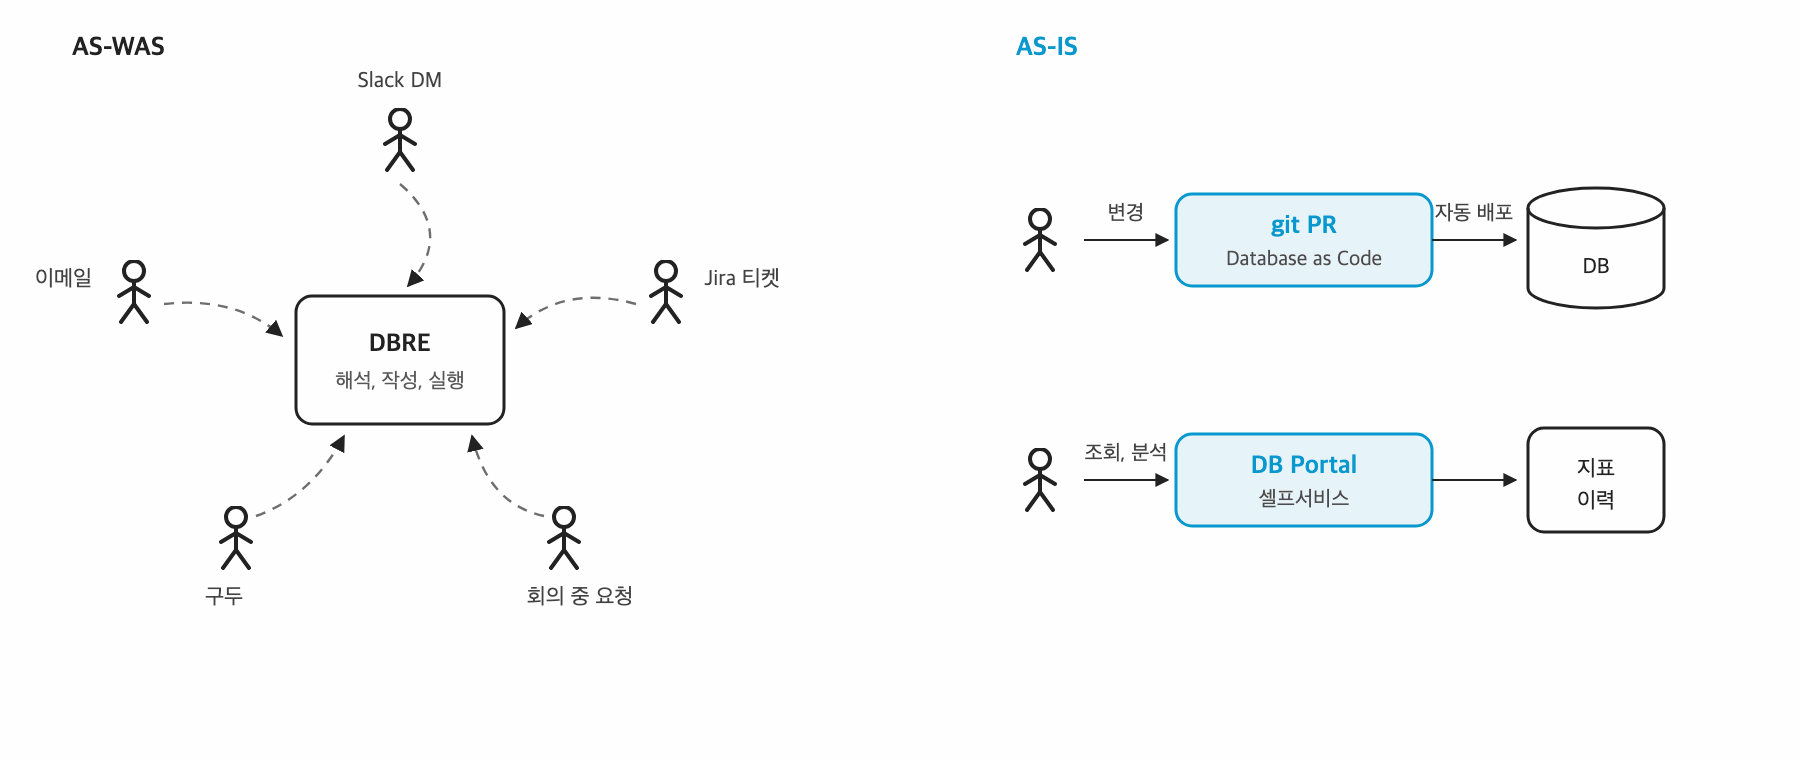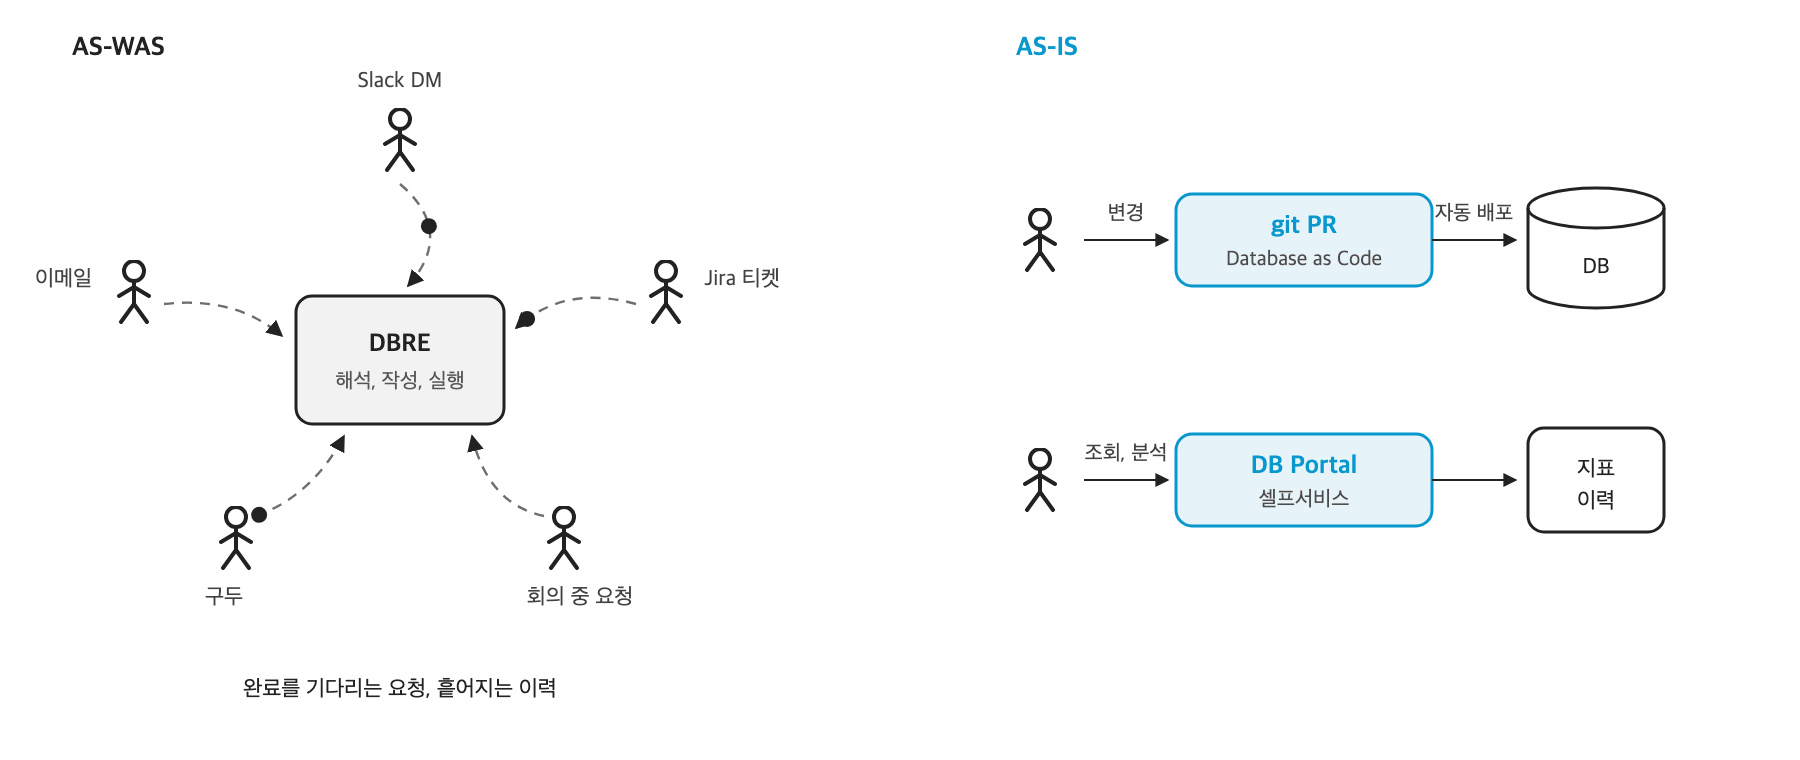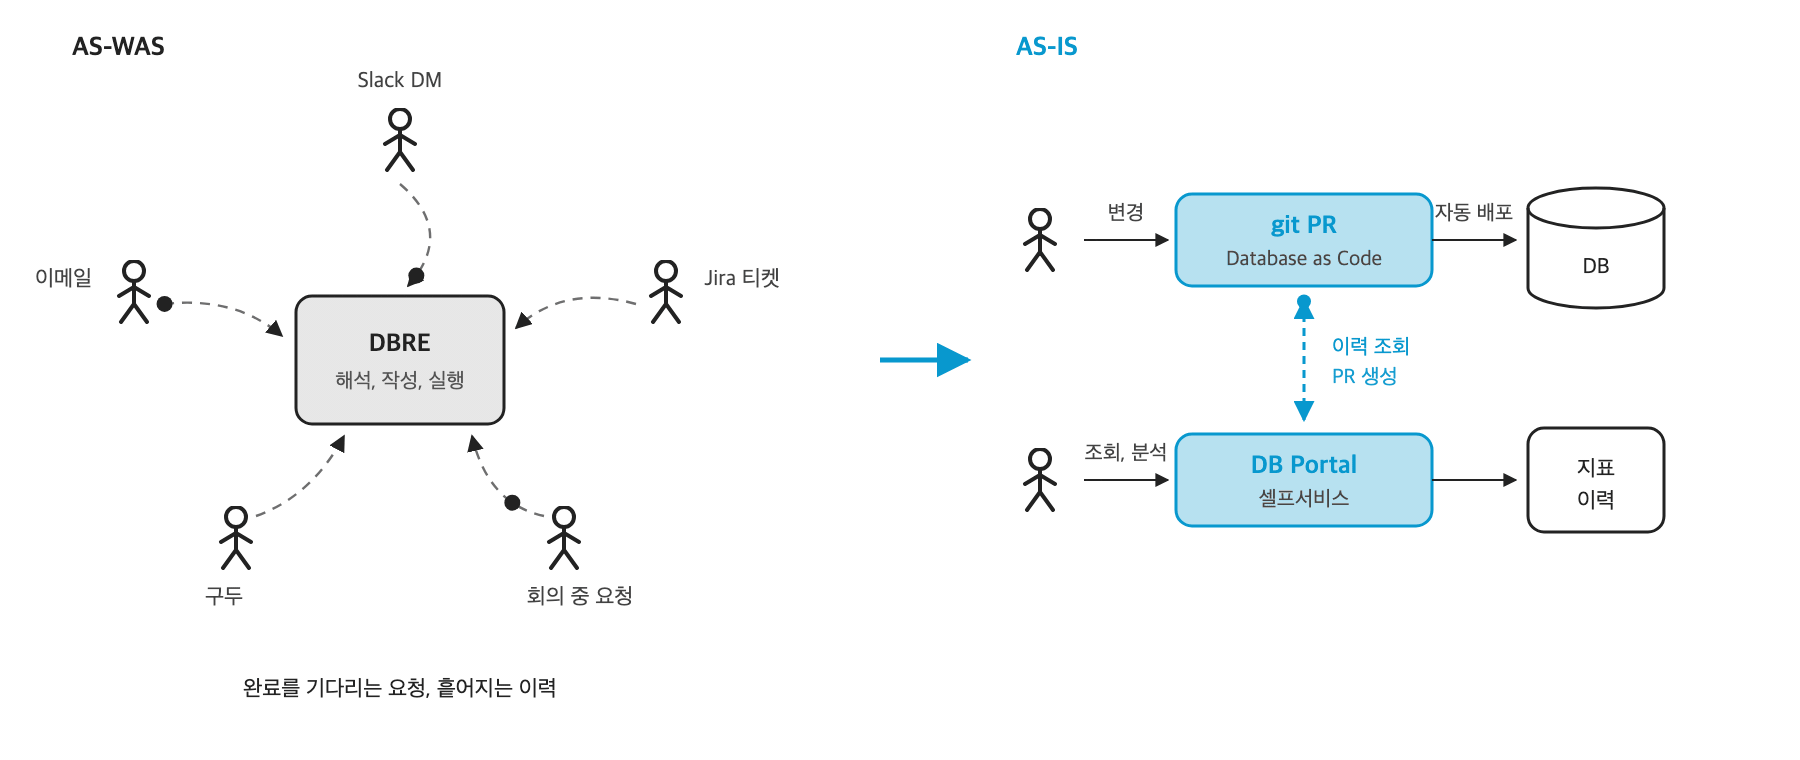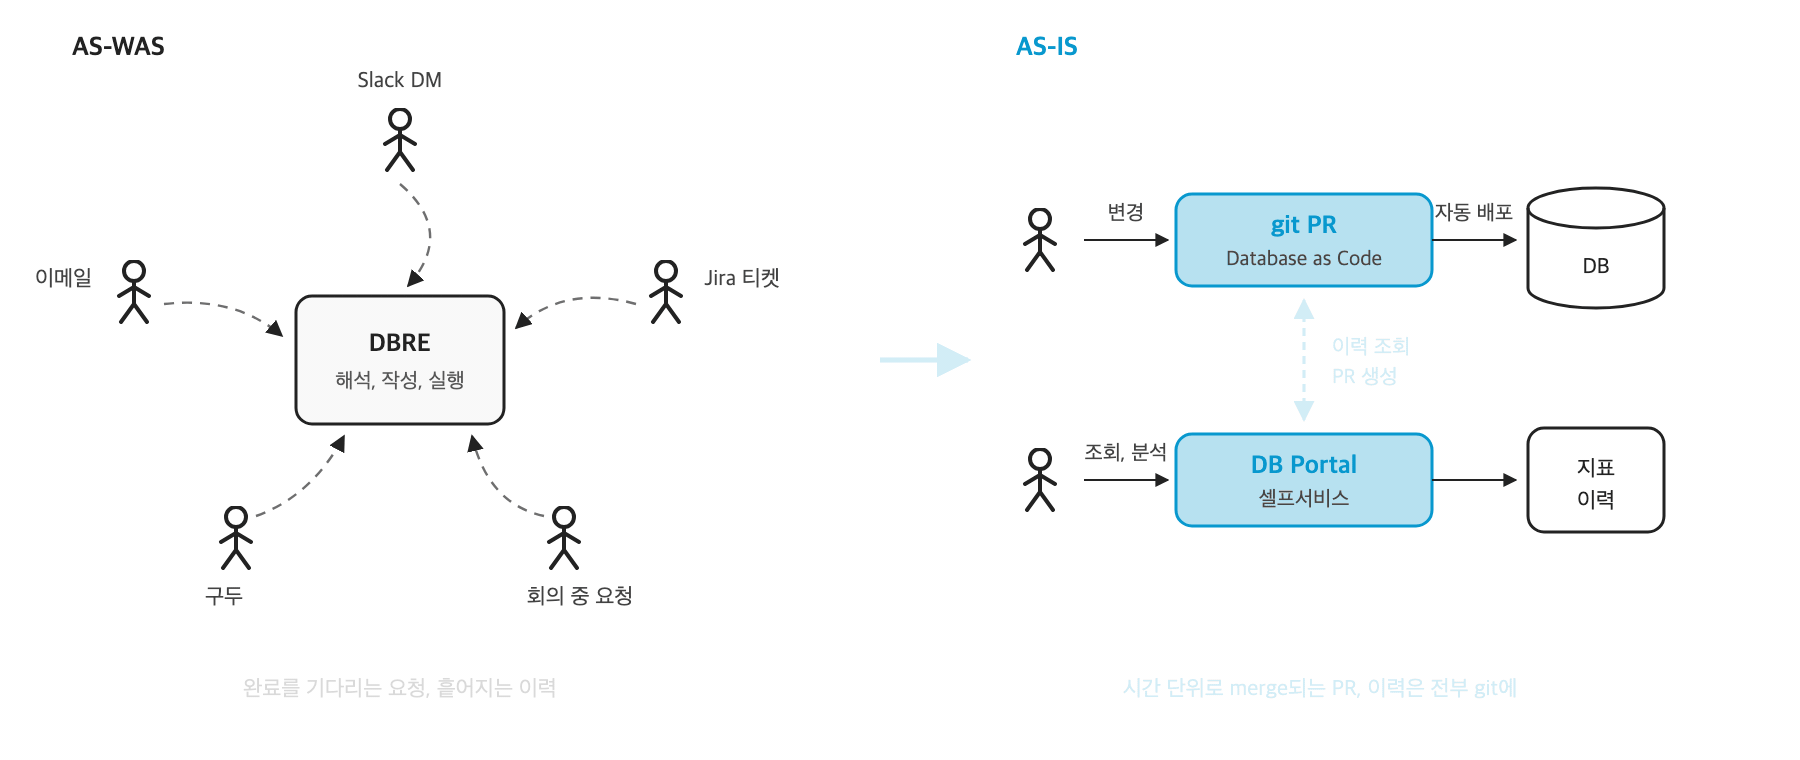
DBRE 팀의 하루는 오랫동안 이런 메시지로 시작됐습니다. 요청은 Slack DM과 Jira 티켓으로, 때로는 구두로 흩어져 들어왔습니다.
검토 정책이 문서로는 있었지만 그것을 적용하는 개개인의 경험과 숙련도가 달랐고, 검증에 쓸 수 있는 환경과 시간도 매번 같지 않았습니다. 변경 이력은 한곳에 모이지 않았습니다. 무엇보다 "이 테이블은 언제, 왜, 어떻게 바뀌어 왔는가"라는 질문에 자신 있게 답할 수 있는 단일한 기준이 없었습니다.
오늘의집 DBRE 팀은 이 문제를 두 갈래로 풀어 왔습니다. 데이터베이스 변경은 코드처럼 git PR로 관리하고(Database as Code, 이하 DaC), 조회와 분석은 개발자가 직접 해결할 수 있는 셀프서비스 도구(DB Portal)로 옮기는 것입니다. 이번 글에서는 이 두 가지 접근을 만들어온 과정과, 그 과정에서 배운 것들을 소개합니다.
DDL 요청은 왜 어려웠을까?
데이터베이스 스키마는 생각보다 자주 바뀝니다. DaC 도입 전인 2024년, DBRE 팀에는 매달 30건 안팎의 DDL 요청 티켓이 들어왔습니다.
요청자가 티켓에 변경 내용을 적으면, DBRE가 의도를 해석해 SQL로 옮기고, 환경별로 직접 실행한 뒤 결과를 회신했습니다. 당시 티켓의 처리 시간을 측정해 보면 요청 하나가 완료되기까지 보통 하루 가까이 걸렸고, 요청의 절반 정도는 하루를 넘겼습니다.
애플리케이션 코드와 달리, 스키마 변경에는 코드 리뷰와 이력 관리라는 개발의 기본 원칙이 적용되지 않고 있었습니다. 스키마의 기준이 되는 형상은 애플리케이션 저장소 어디에도 없었고, Source of Truth는 사실상 운영 DB 그 자체였습니다. 어떤 테이블이 언제, 왜, 어떻게 바뀌었는지 추적하려면 흩어진 티켓과 담당자의 기억을 뒤져야 했습니다.
선언형 스키마 : 저장소가 곧 데이터베이스 형상
그래서 팀은 모든 스키마를 하나의 git 저장소로 모았습니다. 여러 도구 가운데 git을 택한 이유는 단순합니다. 개발자에게 가장 친숙한 시스템이어야 도입의 문턱이 없기 때문입니다. 환경(dev, qa, prod)과 클러스터, 데이터베이스, 테이블 단위로 디렉터리를 나누고, 테이블마다 최종 CREATE TABLE 문을 SQL 파일로 보관합니다. 현재 이 저장소에서 오늘의집이 운영하는 MySQL 스키마와 MongoDB 인덱스 정의를 관리하고 있습니다.
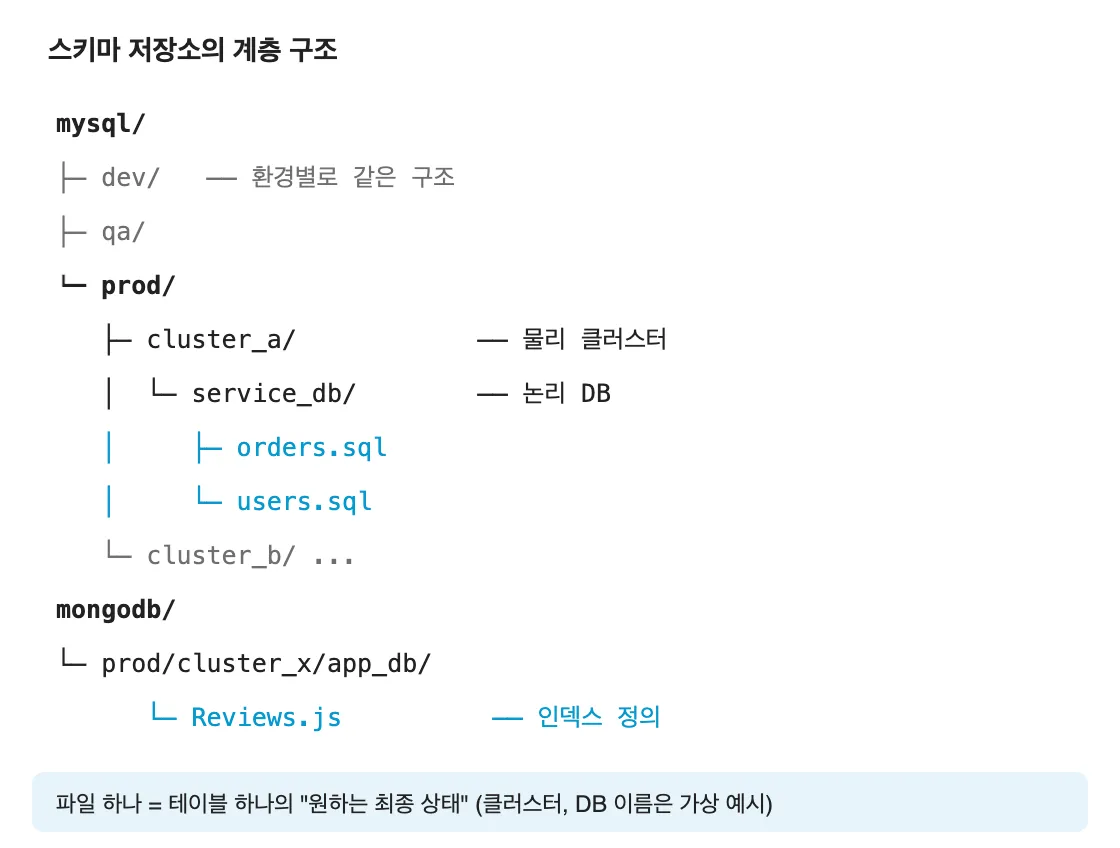
이 구조에서 개발자는 ‘원하는 최종 상태’만 선언합니다. ALTER 문을 직접 작성하지 않습니다. CREATE TABLE 파일을 바꾸고 싶은 모습으로 수정해 PR을 올리면, 현재 상태에서 최종 상태로 가는 방법은 파이프라인이 계산합니다. SQL 쿼리에는 어떤 데이터를 원하는지만 적고 그것을 어떻게 찾을지는 옵티마이저에 맡기듯, 스키마도 같은 원리로 다루기로 한 것입니다.
DDL PR 하나에 담긴 자동화
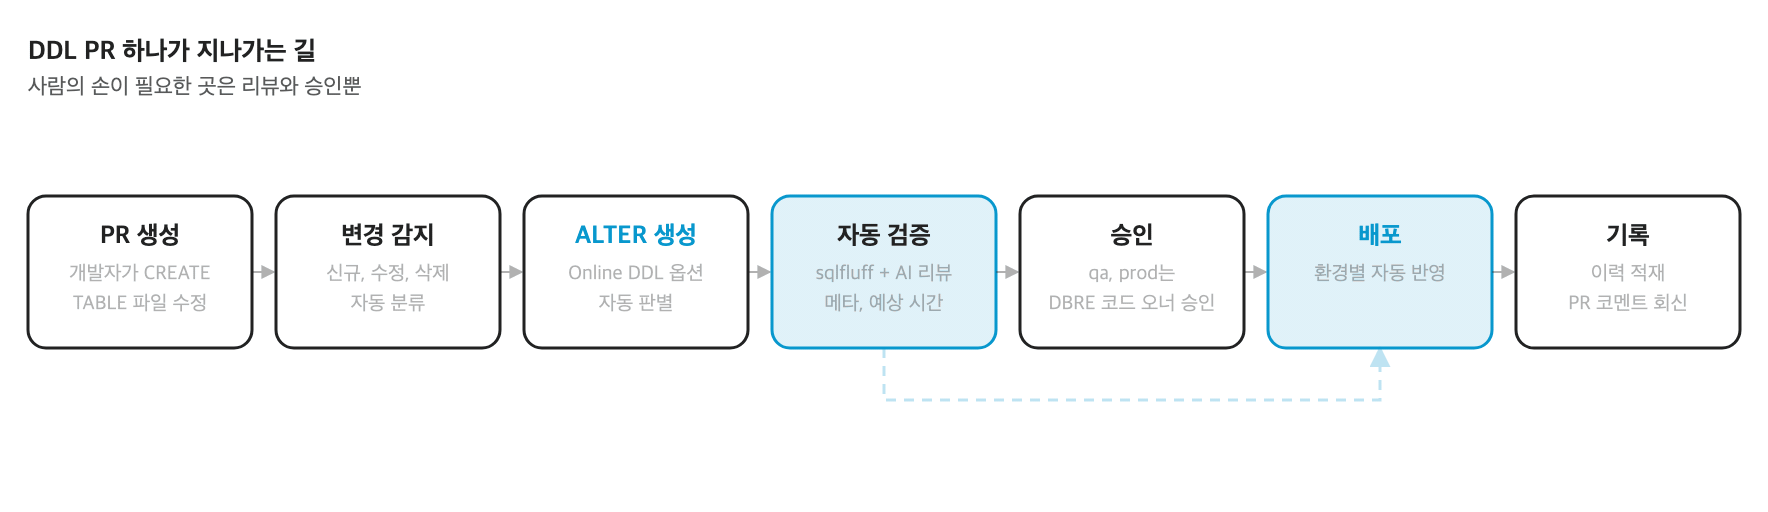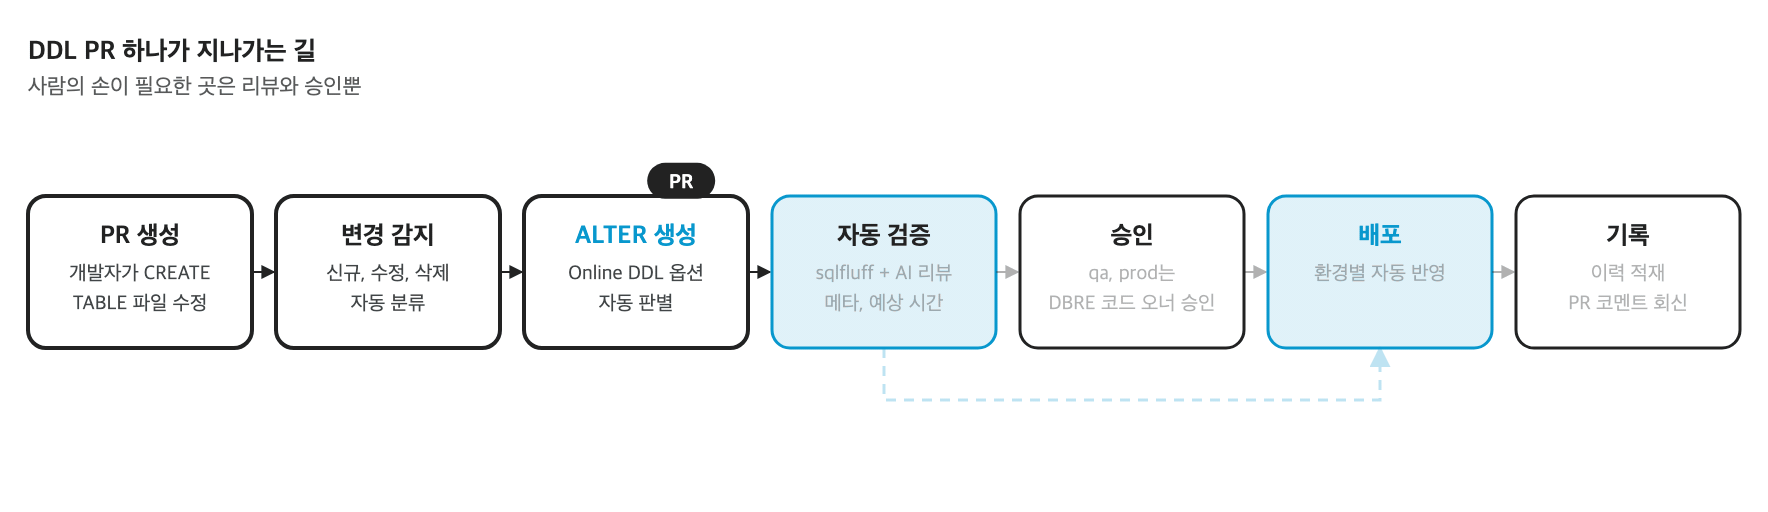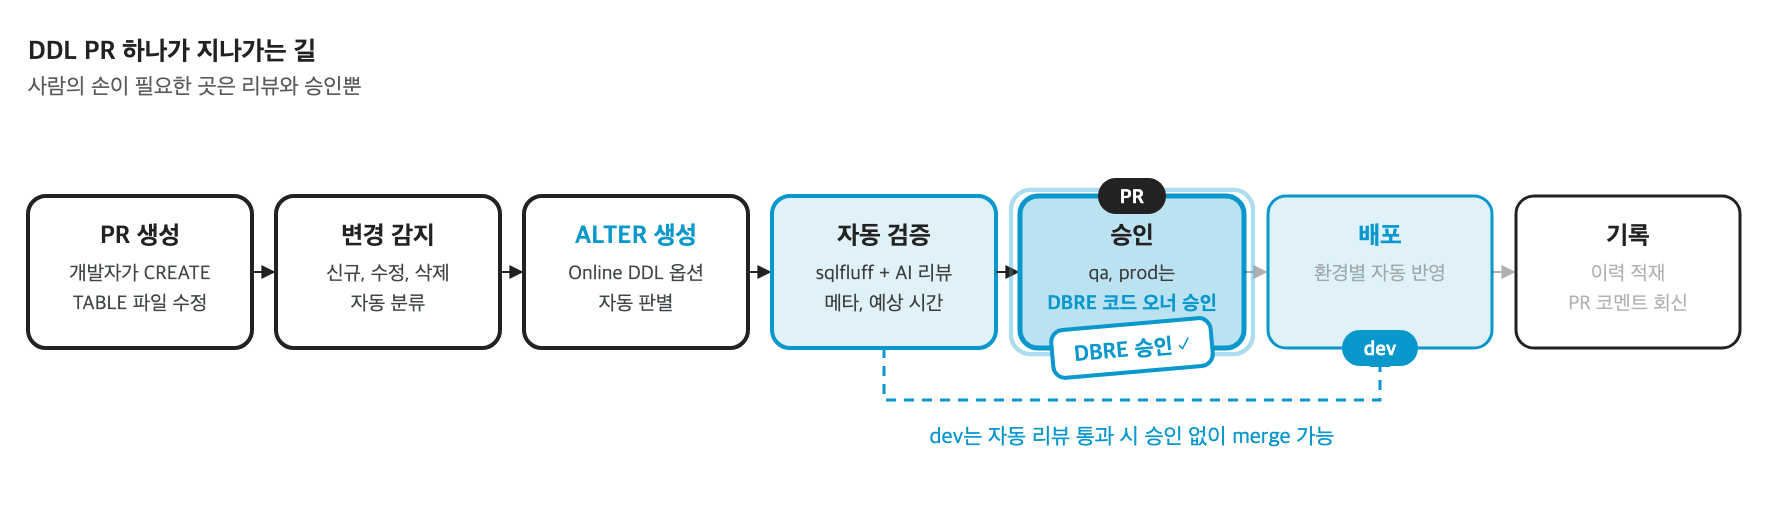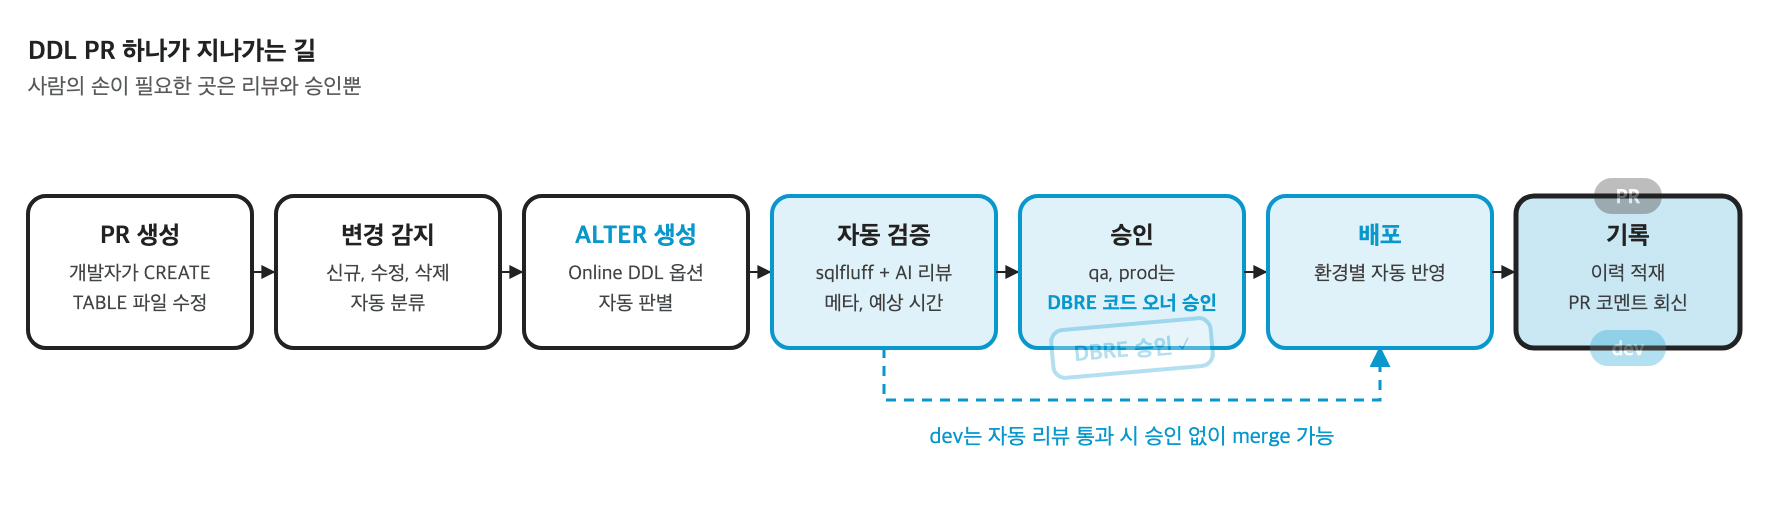
PR 생성부터 운영 반영까지, 사람의 손이 필요한 지점은 리뷰와 승인으로 좁혀집니다.
git diff에서 ALTER SQL까지
PR이 열리면 GitHub Actions가 변경 파일을 감지해 신규, 수정, 삭제로 분류합니다. 수정된 테이블에 대해서는 기존 스키마와 비교해 ALTER SQL을 자동 생성합니다. 이때 운영 중 잠금 영향이 최소화되도록 MySQL Online DDL 옵션(INSTANT, INPLACE, LOCK=NONE)을 판별해 적용합니다. MongoDB도 같은 방식으로 인덱스 정의를 비교해 createIndex와 dropIndex 명령어를 생성합니다.
Skeema나 Atlas 같은 선언형 스키마 도구를 두고 왜 직접 만들었는지 궁금하실 수 있습니다. 두 도구 모두 선언형 관리와 검증 규칙을 제공합니다. 다만 도구마다 지원하는 엔진의 범위가 정해져 있습니다.
팀에 필요했던 것은 여러 엔진을 하나의 저장소와 하나의 리뷰 흐름에서 관리하고, 그 위에 축적해 온 체크리스트를 게이트로 세우는 파이프라인이었습니다. 지금 다루는 것은 MySQL 스키마와 MongoDB 인덱스이지만, 엔진이 늘어나도 같은 흐름을 그대로 쓸 수 있어야 했습니다.
그래서 엔진별 차이를 어댑터로 흡수하는 구조로 직접 만들었고, 선언형 관리 방식은 이런 도구들을 참조했습니다.
AI 리뷰 게이트 : 사람보다 먼저 훑는 눈
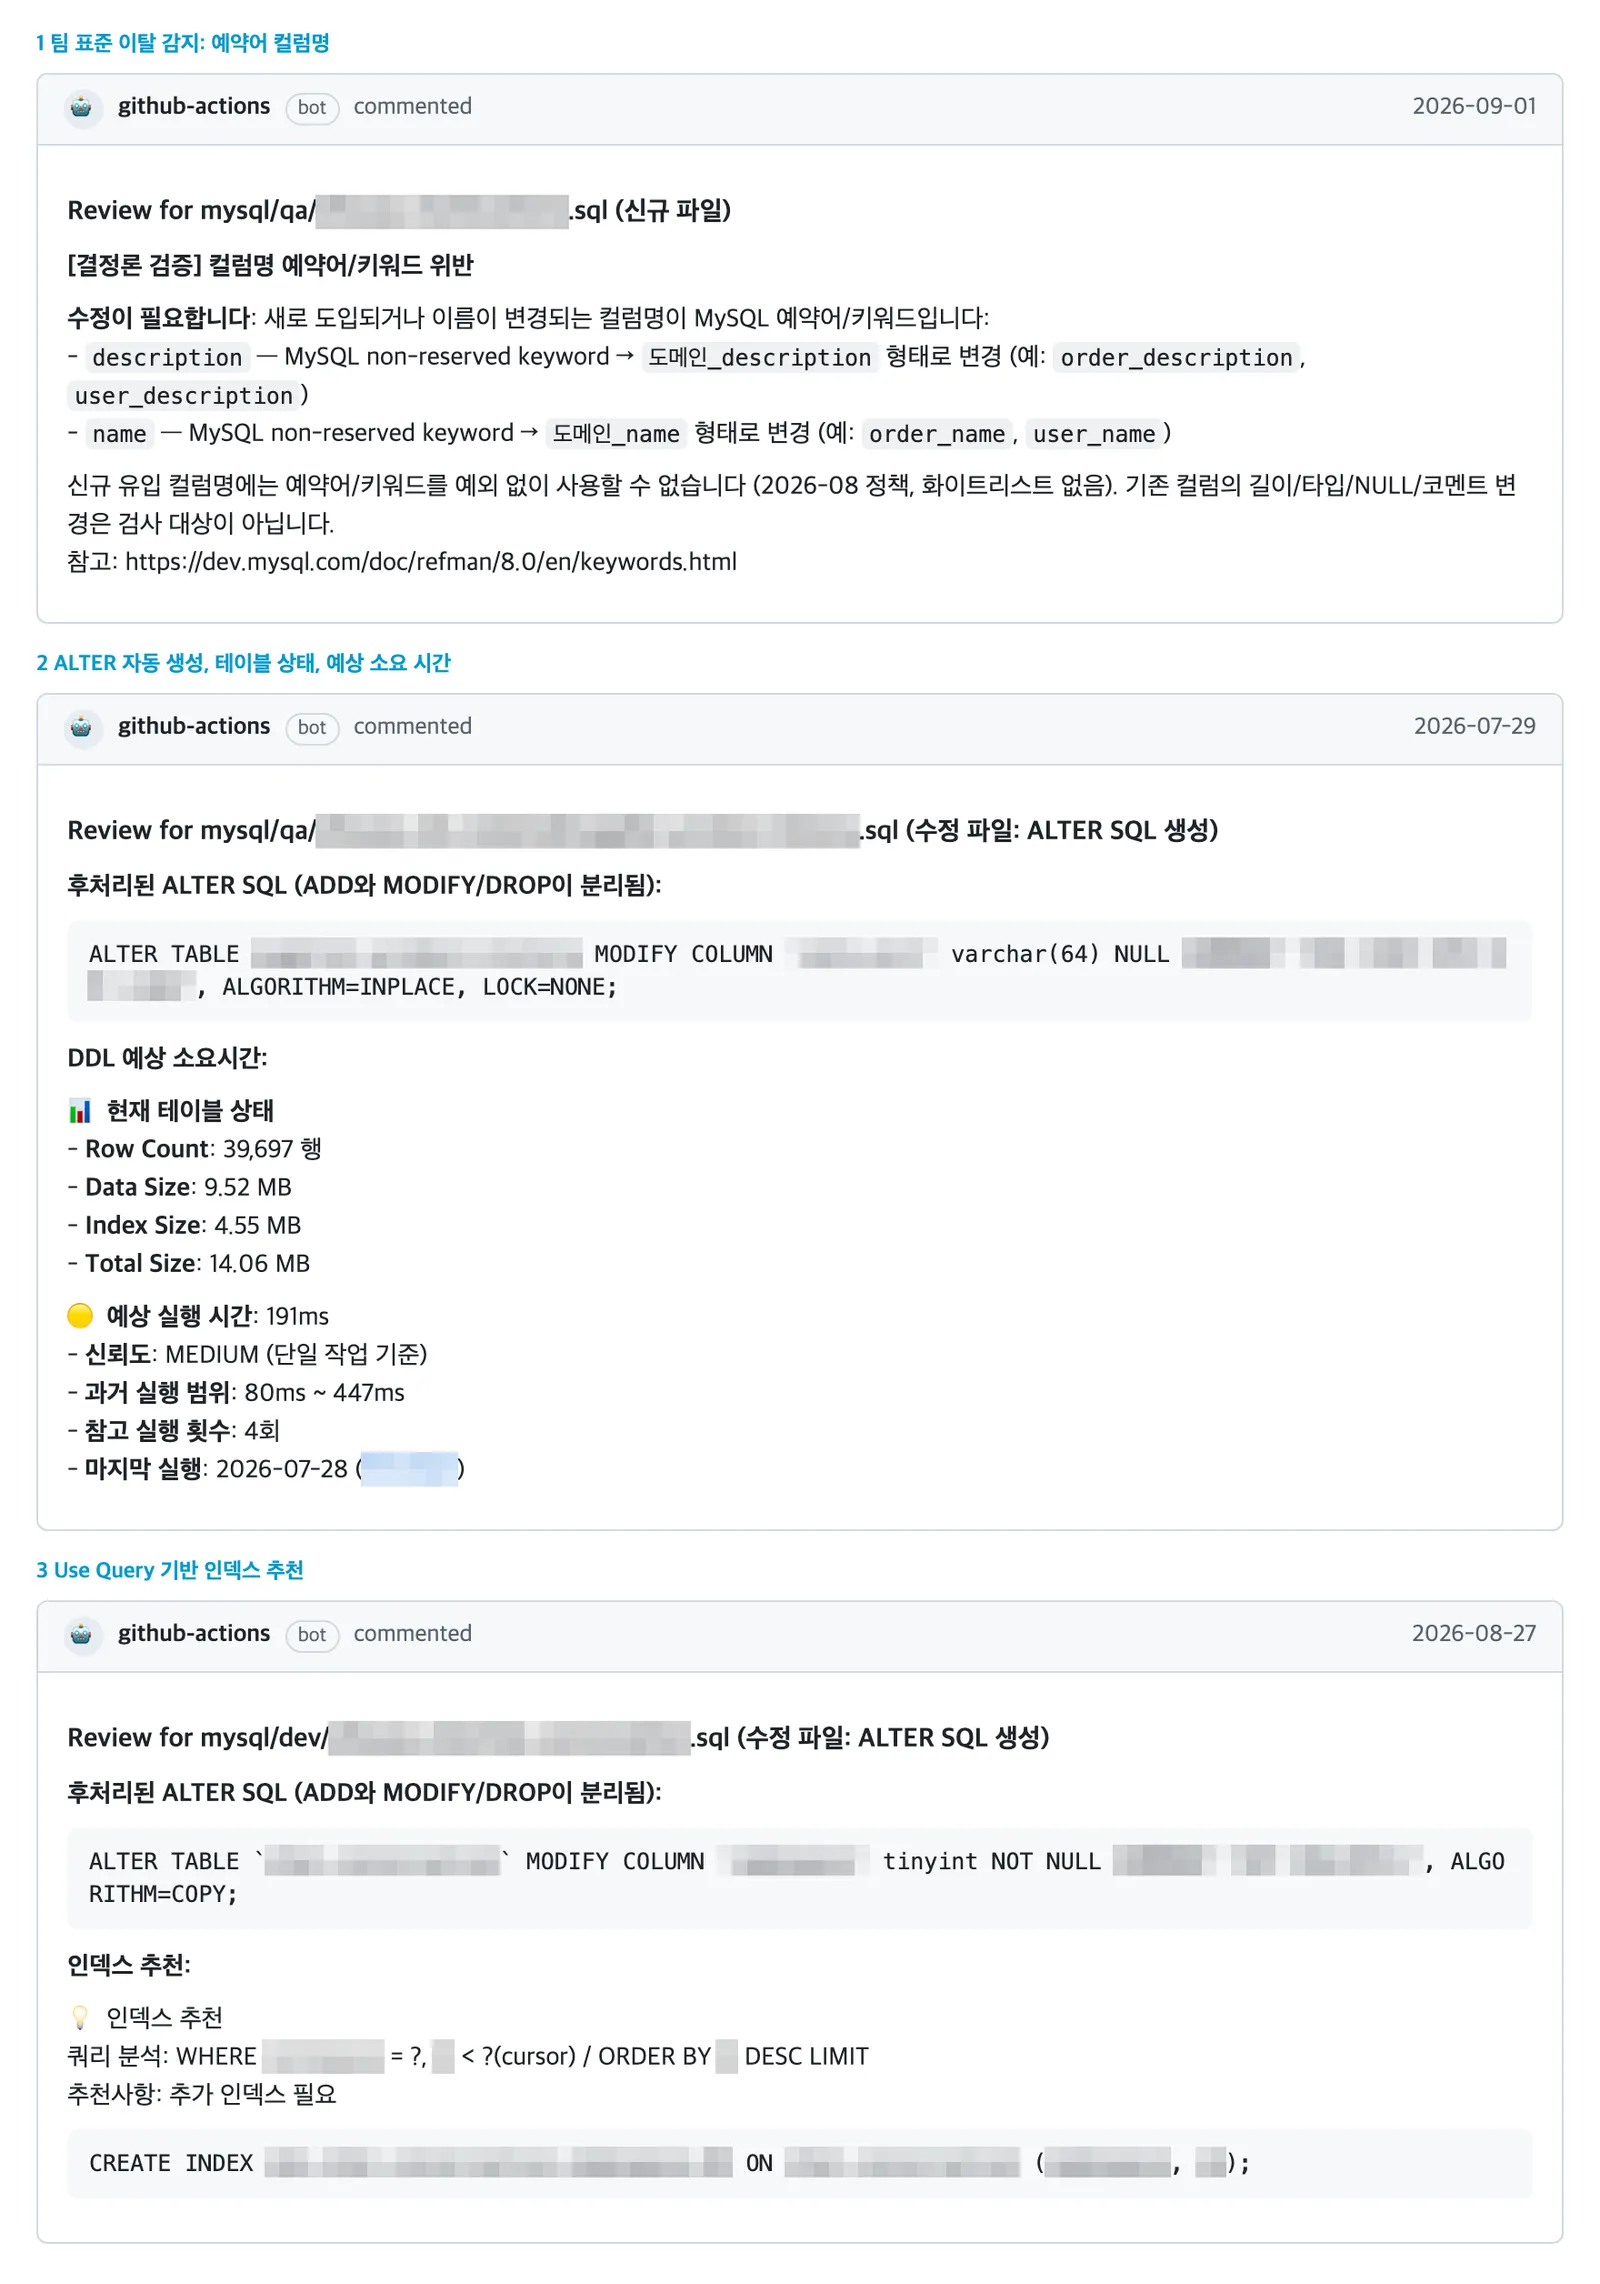
문법은 sqlfluff가 검사하고, 그 외의 검토는 두 단계로 나뉩니다. 예약어를 쓴 칼럼 명이나 명명 규칙에 어긋난 인덱스 이름, 문자열 컬럼 대신 enum을 쓰려는 시도처럼 기준이 분명한 항목은 코드로 걸러냅니다. 반면 규칙만으로 판단하기 어려운 항목은 LLM이 살펴봅니다. 팀이 축적해 온 DDL 체크리스트를 기준으로 살펴 PR 코멘트로 가이드를 남깁니다. 두 단계 중 어디에서든 문제가 발견되면 수정하기 전까지 PR을 merge할 수 없습니다.
리뷰 코멘트에는 판단에 필요한 맥락도 함께 담습니다. 대상 테이블의 현재 크기와 행 수, 인덱스 구성 같은 메타 정보를 조회하고, 같은 테이블의 과거 DDL 실행 이력을 바탕으로 이번 변경의 예상 소요 시간을 신뢰도와 함께 보여줍니다. 단순히 명령어를 만들어 주는 데 그치지 않고, 이 변경이 운영 환경에 얼마나 부담을 줄 수 있는지 PR 안에서 미리 가늠할 수 있게 한 것입니다. 리뷰 내용을 바로 반영하고 싶다면 특정 코멘트를 남기는 것만으로 별도의 commit이나 push 없이 수정 사항을 적용할 수도 있습니다.
다만 모든 판단을 자동화에 맡기지는 않습니다. 자동 검사를 통과하더라도 qa와 prod에 반영하려면 DBRE의 approve가 필요합니다. 규칙이나 LLM이 놓친 위험을 사람이 마지막으로 확인하는 구조입니다.
자동 리뷰 자체의 품질도 지속적으로 관리합니다. 프롬프트는 Langfuse에서 중앙 관리하고, DBMS별 템플릿은 버전 관리하며 계속 개선합니다. 또한 정답이 정해진 테스트 케이스로 매주 LLM 리뷰를 다시 실행해 품질이 떨어지지 않았는지도 확인합니다. 문제없는 변경을 LLM이 잘못 막는 오탐이 발생했을 때도 단순히 예외 처리하고 넘어가지 않고, 원인을 찾아 리뷰 기준을 보완합니다. 자동화의 범위를 넓히되, 그 판단에 오류가 있음을 전제로 검증과 개선을 이어가는 것입니다.
위험한 변경을 막는 안전장치
배포 정책은 환경의 성격을 따릅니다. dev는 이름 그대로 개발을 위한 환경이므로, 자동 리뷰의 최소 요건만 통과하면 바로 반영되도록 해 개발 작업이 지연되지 않게 했습니다. 반면 qa와 prod는 안정성이 우선입니다. 두 환경은 코드 오너의 승인을 거친 뒤에만 반영됩니다.
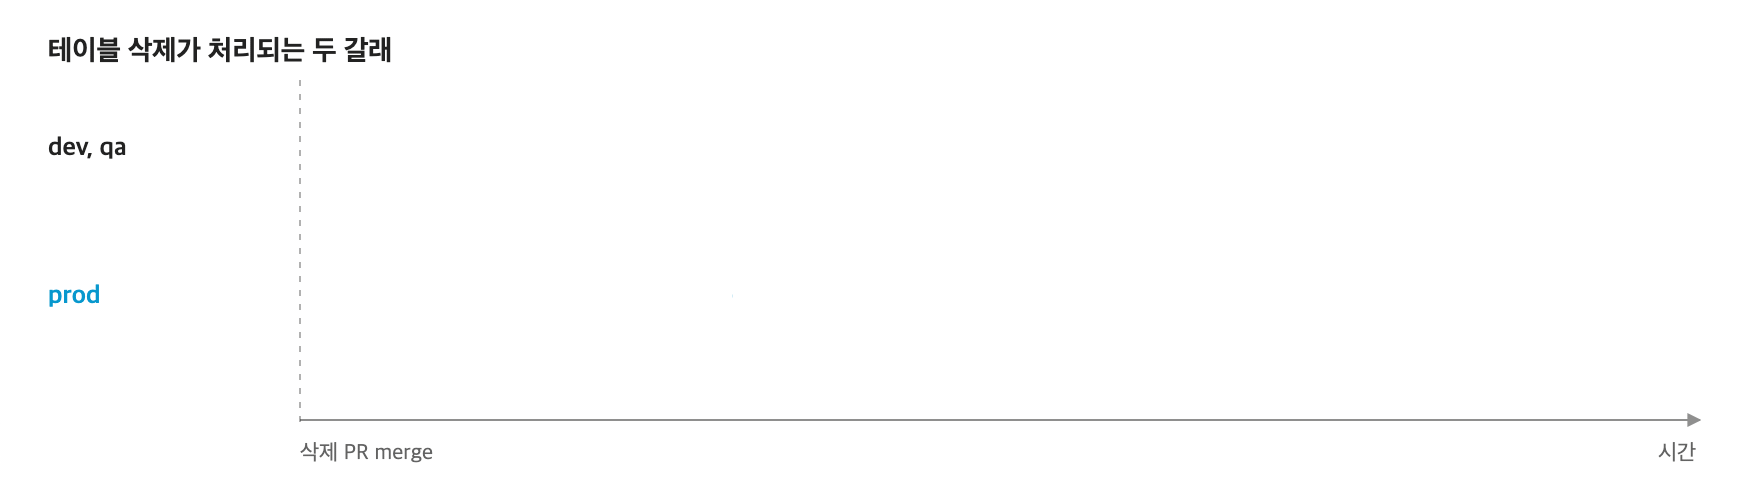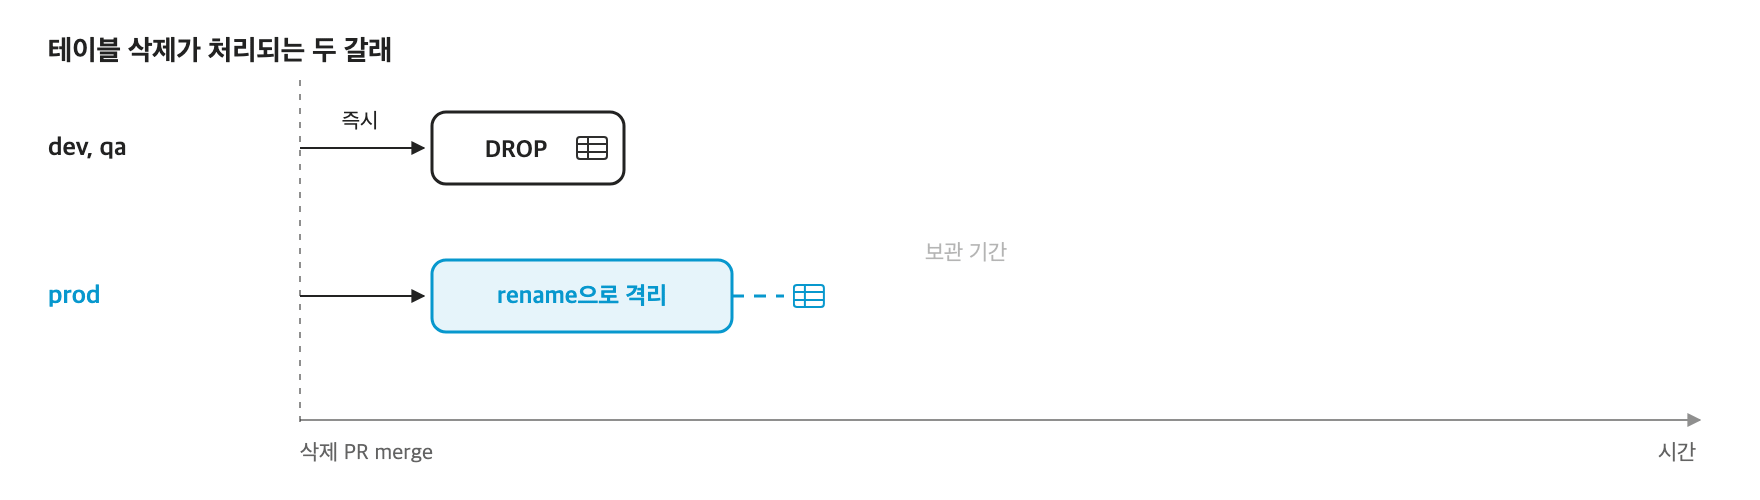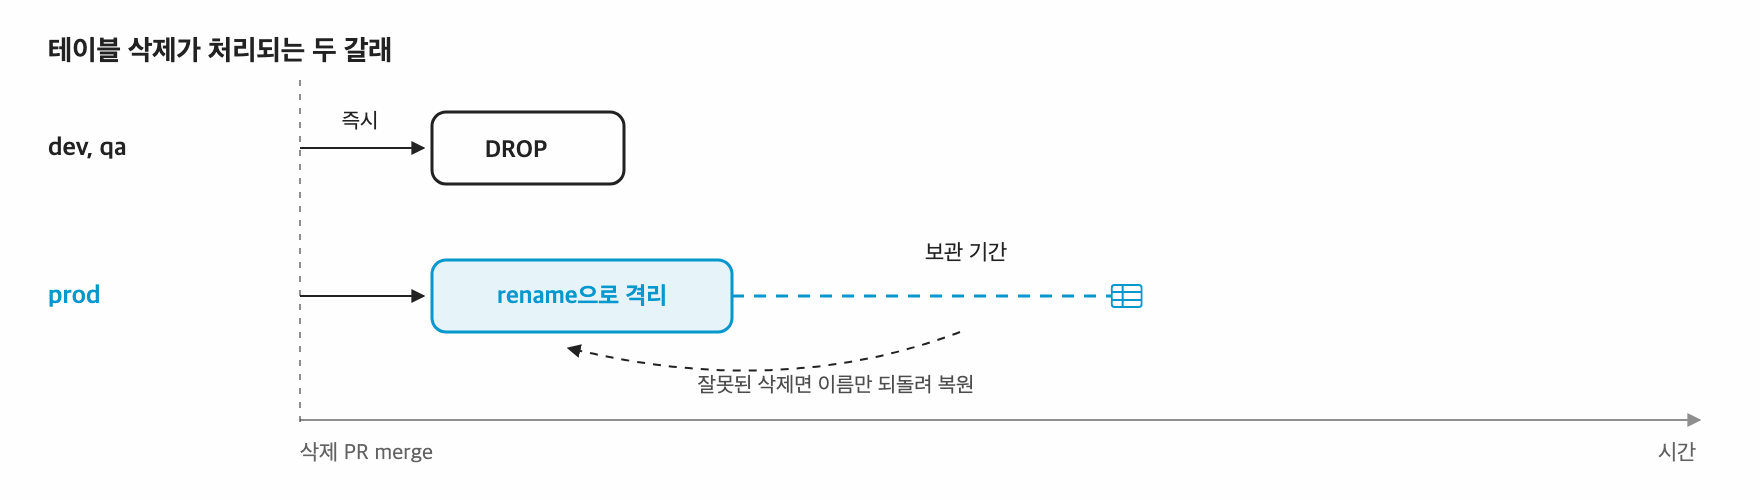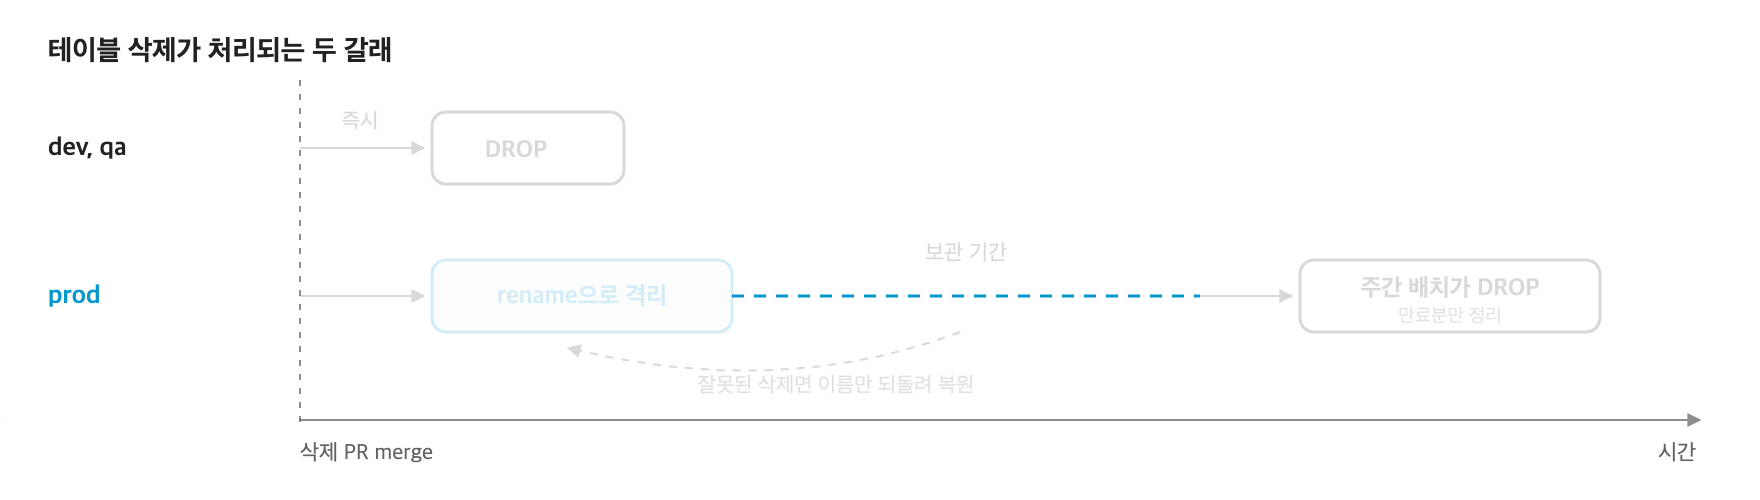
테이블 삭제는 특히 조심스럽게 다룹니다. prod에서는 DROP을 바로 실행하지 않습니다. 테이블을 rename으로 격리해 일정 기간 보관한 뒤 배치로 정리하는 rename-then-batch 방식을 사용합니다. 삭제 요청이 잘못된 판단에서 나왔더라도 되돌릴 수 있는 시간을 남겨두는 것입니다. 파이프라인은 이름 규칙으로 격리된 테이블을 구분하기 때문에, 이후 변경을 감지할 때 이를 일반 삭제나 신규 생성으로 오판하지 않습니다.
모든 실행 기록은 이력 테이블에 쌓이고, 배포 성공과 실패는 PR 코멘트로 돌아옵니다. 변경을 올린 개발자는 자신의 PR 화면만 보면 됩니다.
새 데이터베이스가 필요할 때 : 프로비저닝 자동화
새 서비스를 시작할 때도 개발자는 같은 저장소에 스키마나 인덱스 정의 파일을 추가해 PR을 올립니다. merge되면 배포 파이프라인이 데이터베이스를 만들고, 계정과 권한을 설정하고, 접속 정보를 발급합니다. 세부 절차는 데이터베이스 종류와 환경에 따라 나뉘지만, 개발자가 PR 하나로 요청하고 결과를 확인한다는 점은 같습니다.
이 단계들은 오랫동안 사람이 직접 해 왔습니다. 지금은 비밀번호까지 파이프라인이 만듭니다. 팀은 계정과 권한 관리 전반으로 이 방식을 넓히는 것도 검토하고 있습니다.
DB Portal : 조회와 분석의 셀프서비스
변경이 git으로 정리되자 다음 병목이 보였습니다.
"제 테이블 얼마나 커졌어요?"
"이 쿼리 왜 느려요?"
DB의 현재 상태나 정보를 확인하려면 여전히 DBRE를 거쳐야 했습니다.
DB Portal은 이런 질문에 개발자가 직접 답을 찾도록 만든 웹 포털입니다. DBRE 팀이 운영하는 모든 데이터 스토리지를 한곳에서 다룹니다.
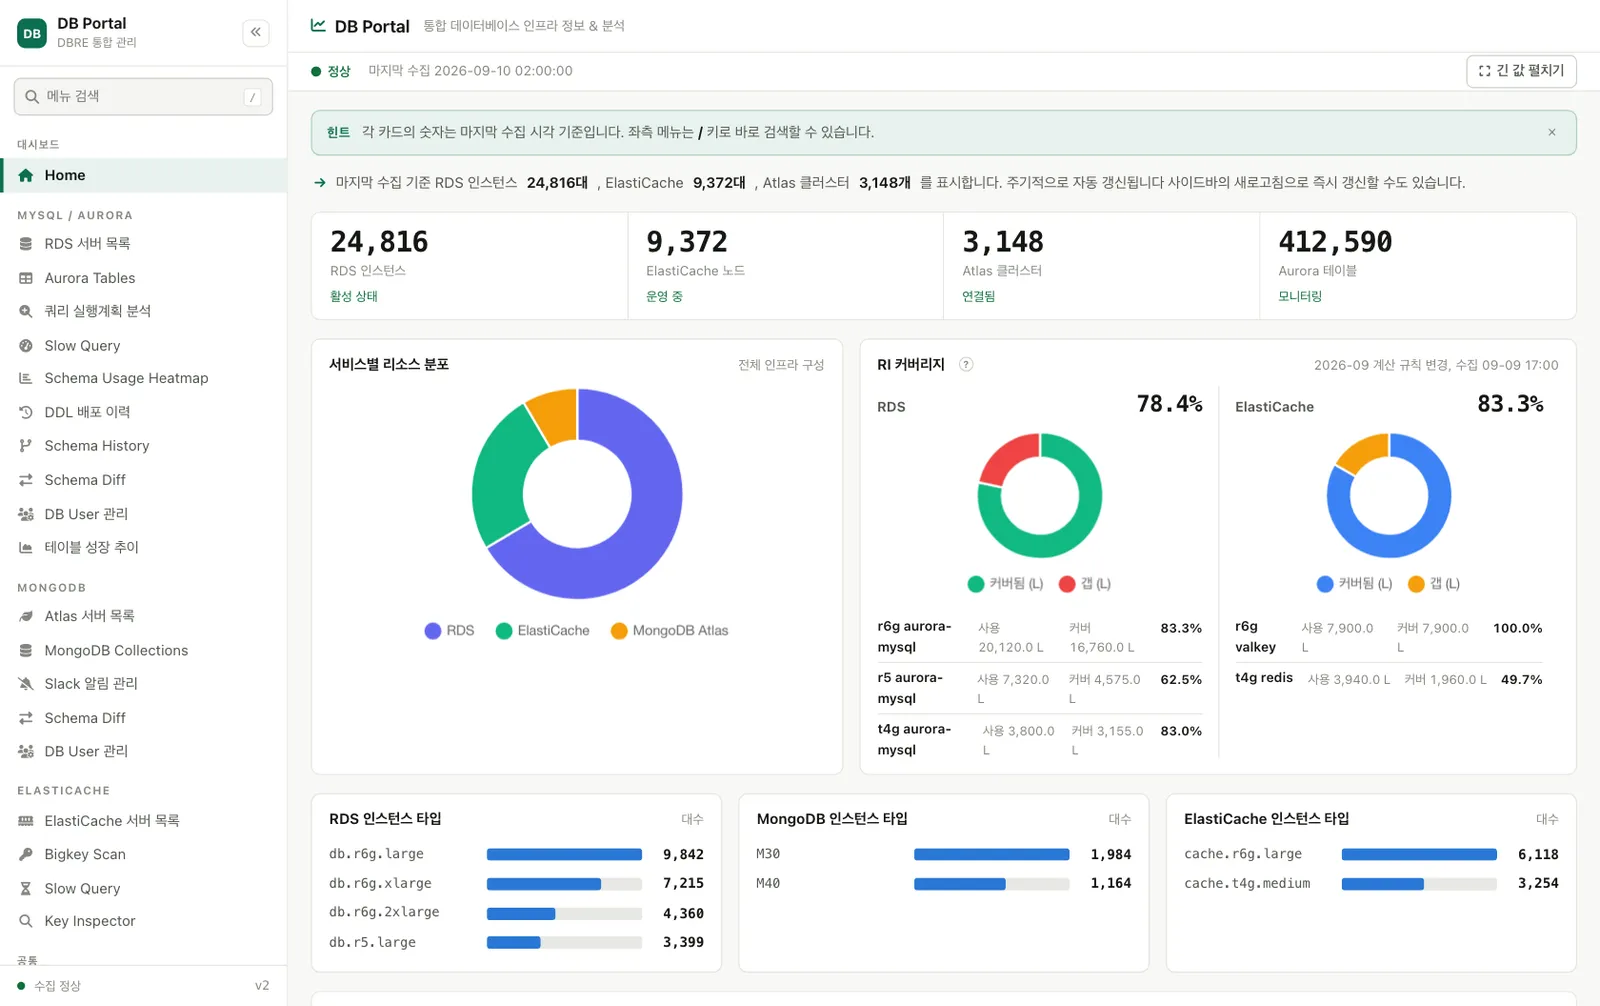
"이 쿼리 왜 느려요?"에 답하는 도구들
질문의 종류에 따라 도구가 나뉩니다.
- Slow Query 조회: CloudWatch Logs와 pt-query-digest를 통합해 기간별 Slow Query를 한 화면에서 확인합니다.
- Query Analyzer: EXPLAIN 실행 계획에 AI 기반 인덱스 최적화 제안을 더합니다.
- Schema History: 테이블이 언제 어떤 PR로 바뀌었는지 실행 이력으로 보여줍니다.
- DDL Deploy History: 환경별 반영 결과를 추적합니다.
- Table Growth: 테이블별 크기 추이를 보여줍니다.
이 밖에도 백업 상태와 Reserved Instance 커버리지 같은 운영 현황을 포털에서 함께 관리합니다.
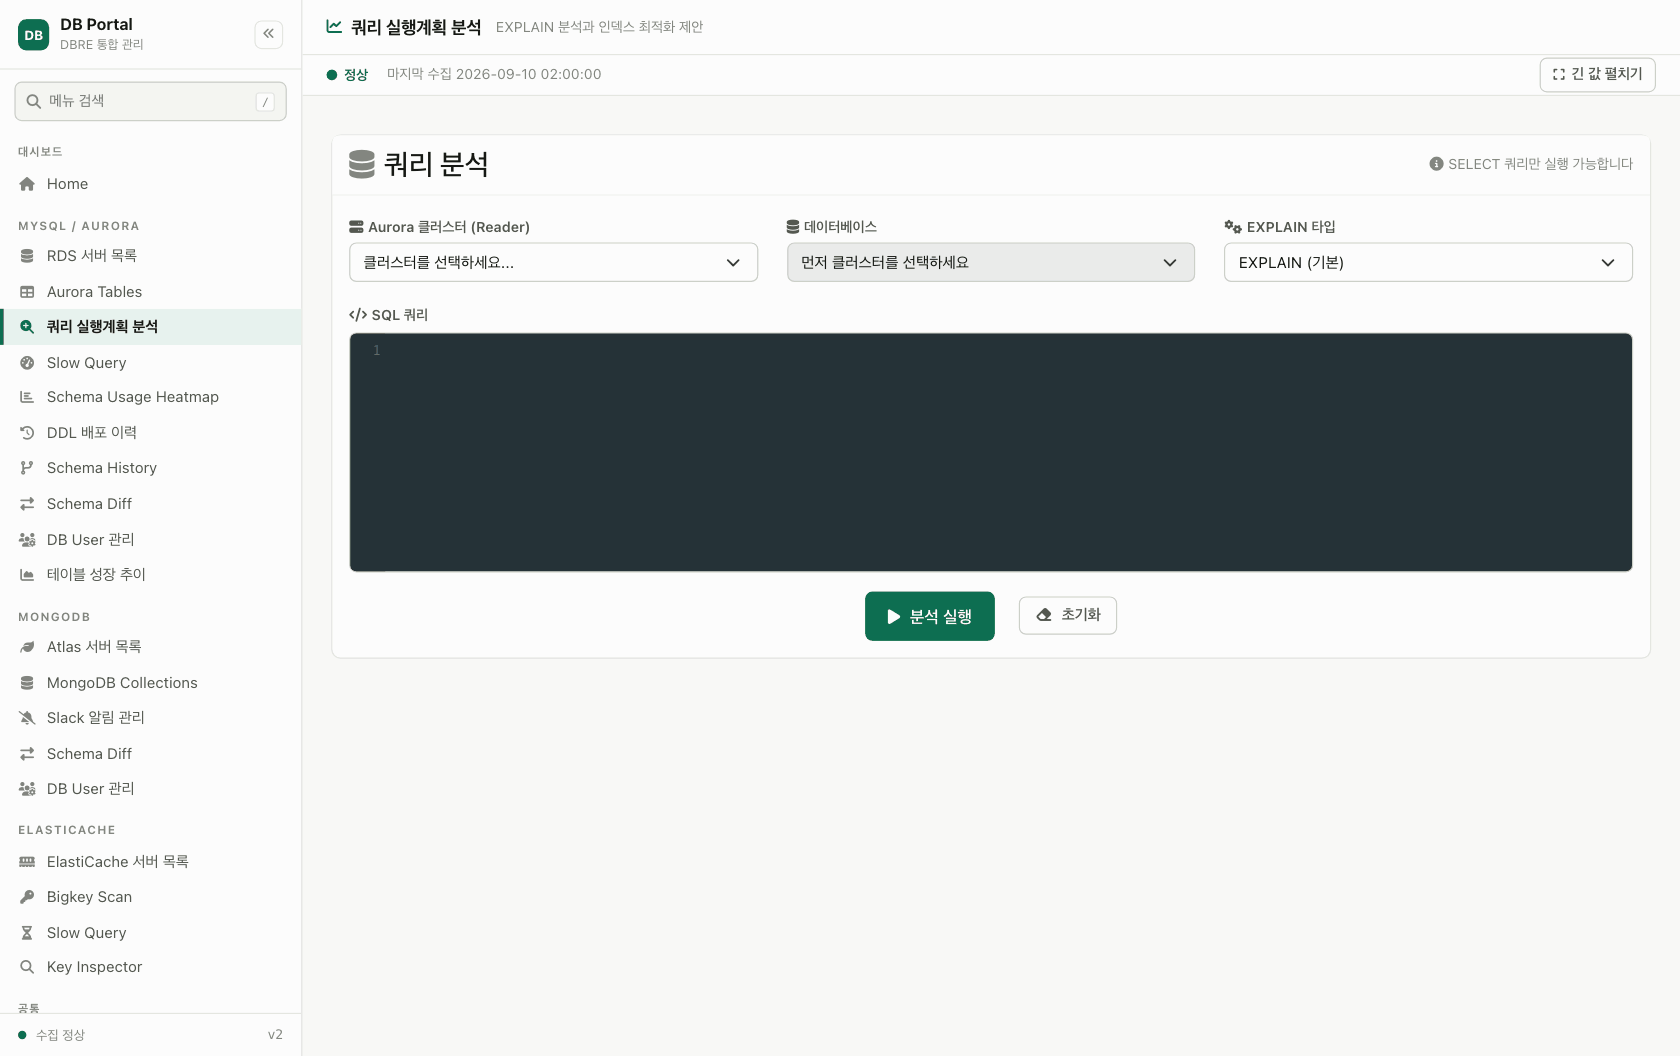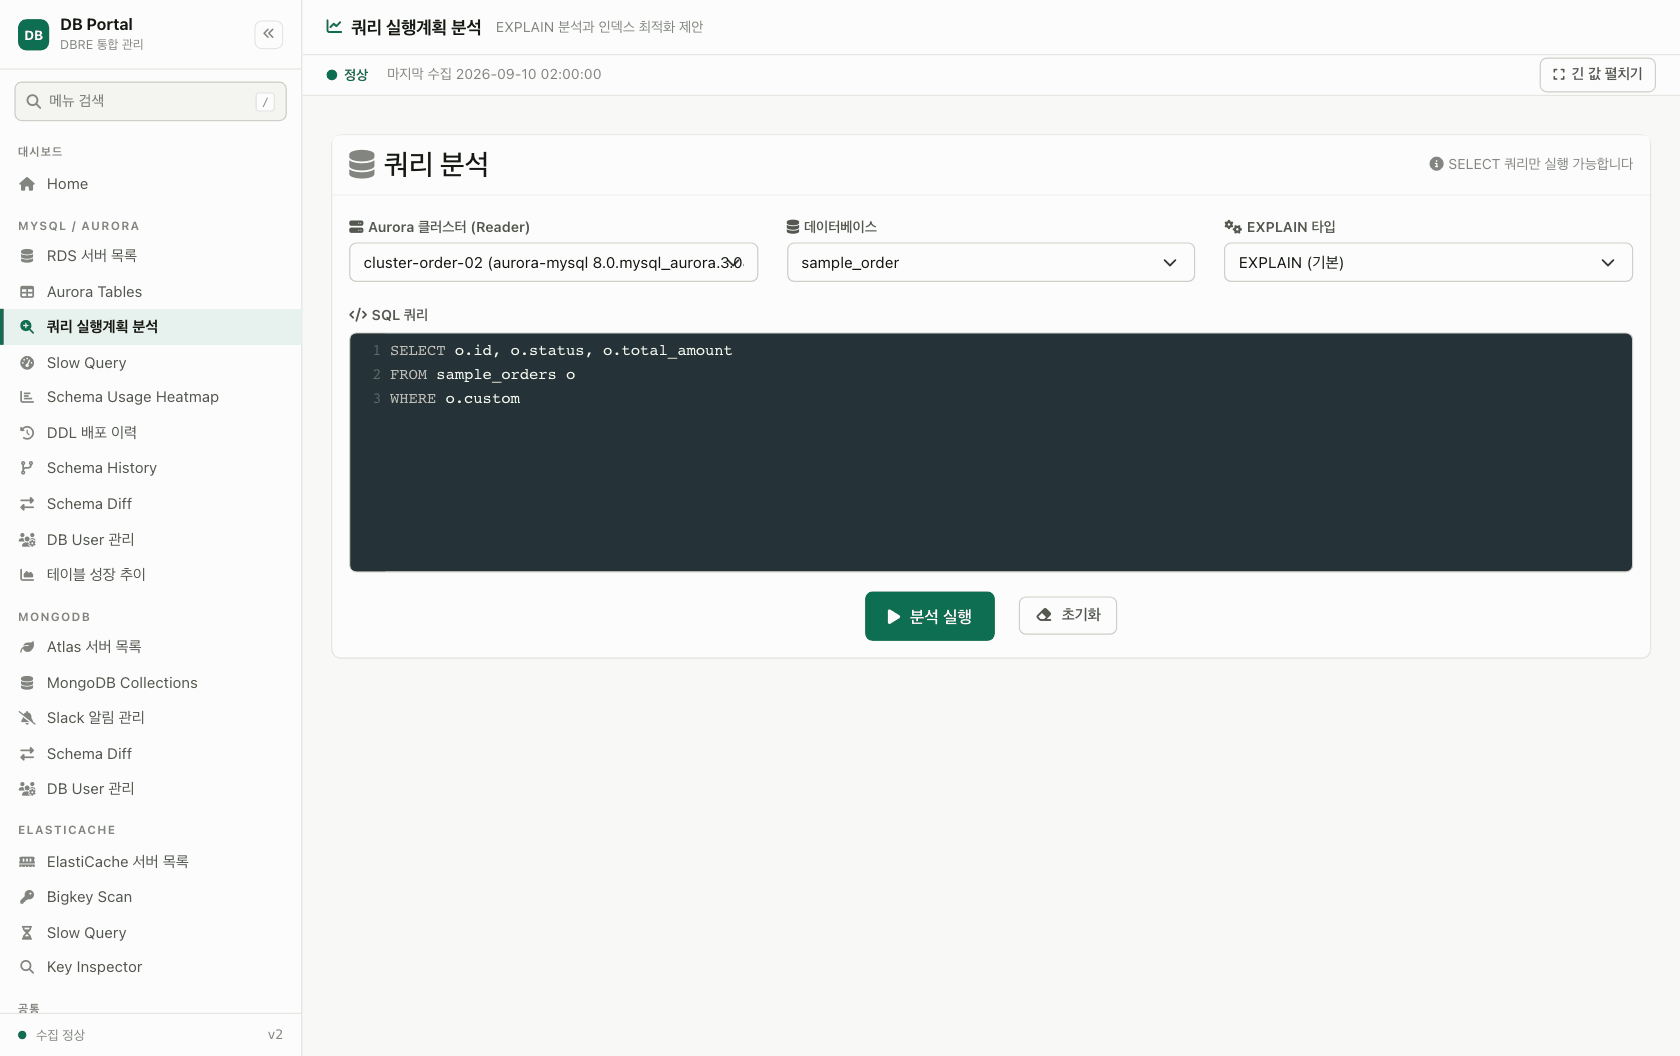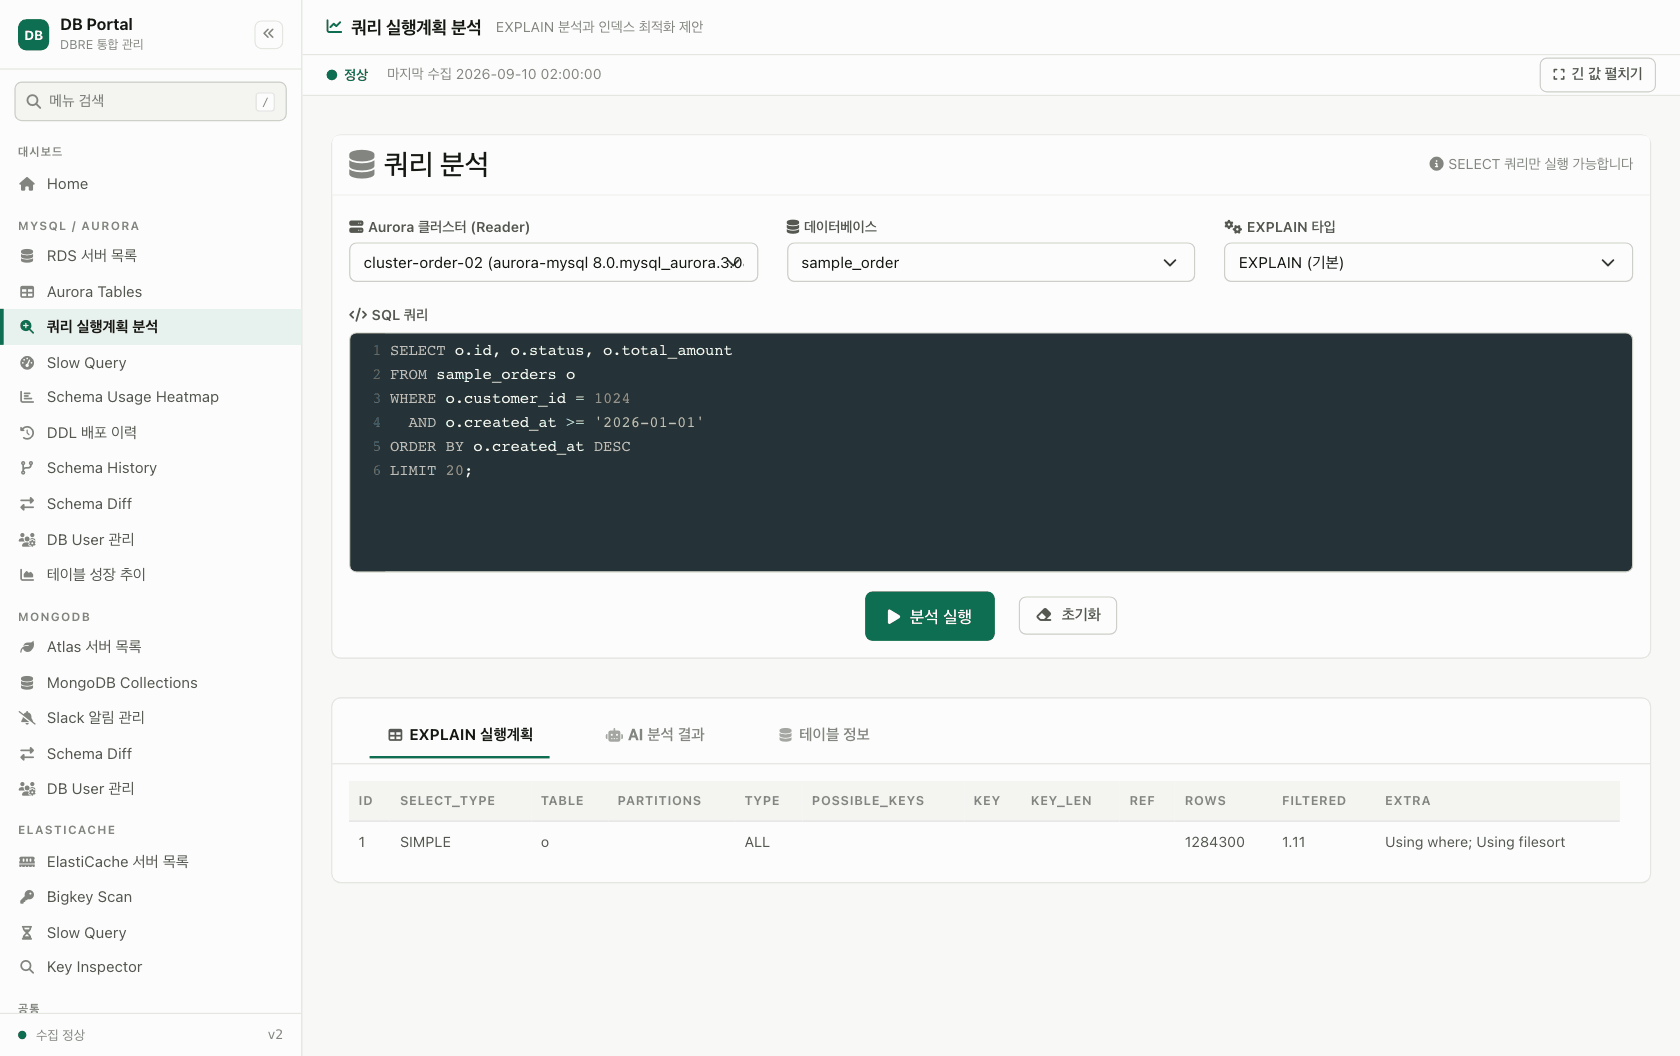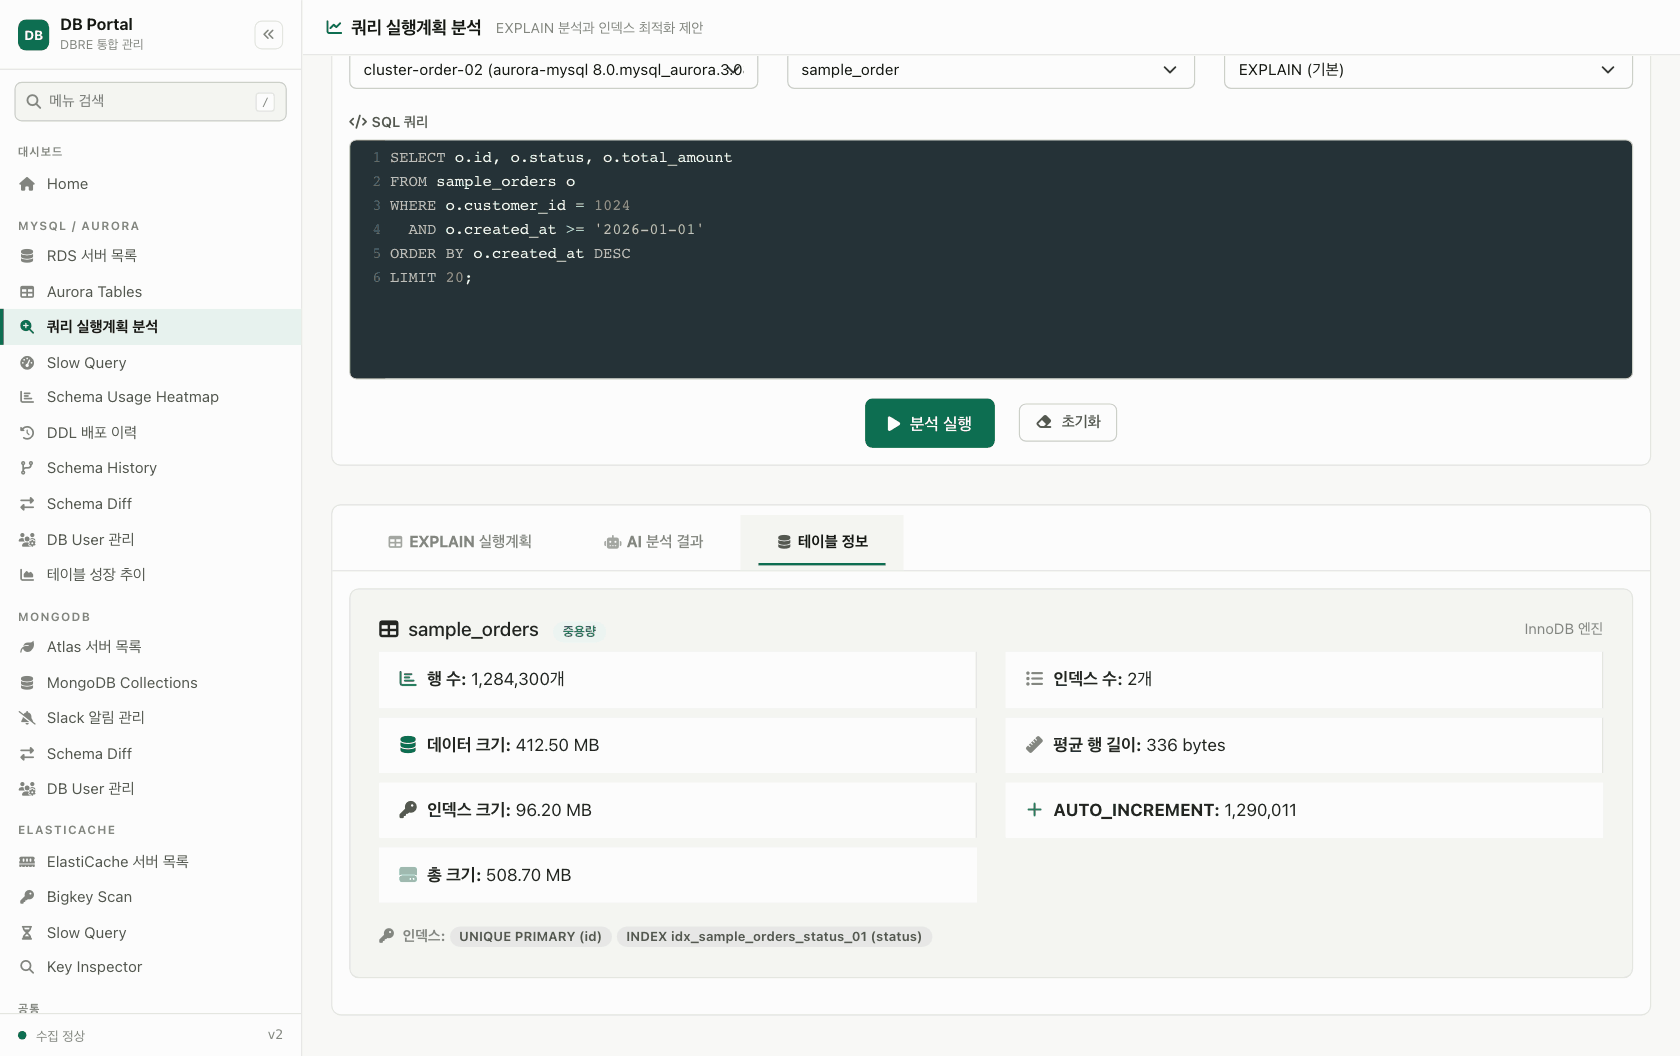
조회는 변경으로 이어집니다. 환경 사이에 형상이 어긋난 테이블을 발견하면 스키마 파일을 운영 쪽에 맞추는 PR을, 쓰이지 않는 인덱스를 찾으면 지우는 PR을 그 자리에서 올릴 수 있습니다.
이런 PR도 개발자가 직접 올린 PR과 같은 파이프라인을 지납니다. 반대 방향도 있습니다. 방금 소개한 Schema History와 DDL Deploy History가 보여주는 이력은 그 파이프라인이 남긴 실행 기록입니다. 두 갈래로 소개했지만, 실제로는 PR과 실행 기록이 둘 사이를 오갑니다.
숫자로 확인한 수요
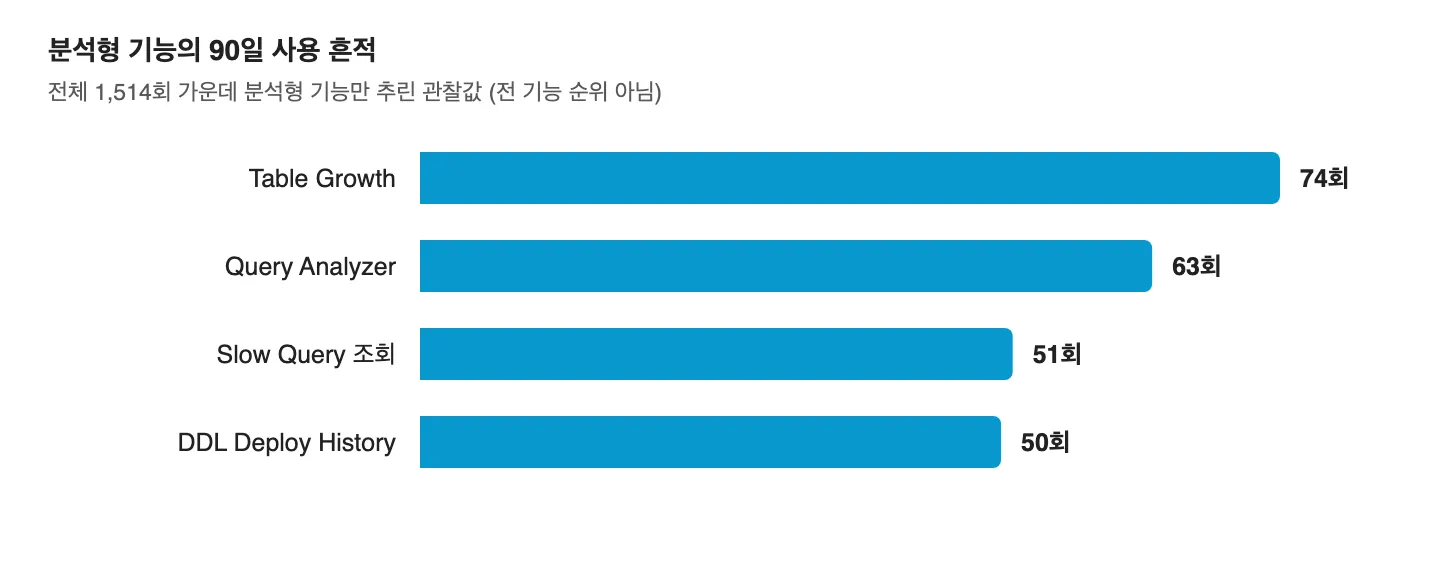
최근 90일 동안 약 120명의 사용자가 포털의 28개 기능을 총 1,514회 사용했습니다. 조회 기능에 더해 분석형 기능의 사용도 확인됐습니다. Table Growth 74회, Query Analyzer 63회, Slow Query 조회 51회, DDL Deploy History 50회. 개발자들이 DB의 상태와 성능을 스스로 확인하고 싶어 한다는 사실이 숫자로 드러났습니다. 예전이라면 이 가운데 상당수는 DBRE에 질문으로 왔을 것입니다.
실패에서 배운 것 : Portal Assistant의 퇴장
모든 시도가 성공한 것은 아니었습니다. 되돌아보면 당시 팀은 AI의 능력을 다소 과대평가하고 있었습니다. 그 기대 위에서 만든 GPT 기반 대화형 어시스턴트 Portal Assistant는 2,468줄의 코드로 시작해 기능을 더해 갔지만, 약 6개월 뒤 3,222줄을 들어내며 퇴장했습니다. 범용 챗봇보다 쿼리 분석이나 DDL 리뷰처럼 특정 작업에 붙은 AI가 훨씬 많이 쓰였기 때문입니다.
이 경험 뒤로 팀은 사용 근거 없이 큰 기능부터 만들지 않기로 했습니다. 새 기능 개발은 실사용 데이터로 수요를 먼저 확인하고 시작하는 방향으로 바꿔 가고 있습니다.
도입 전후를 실측으로 비교하면
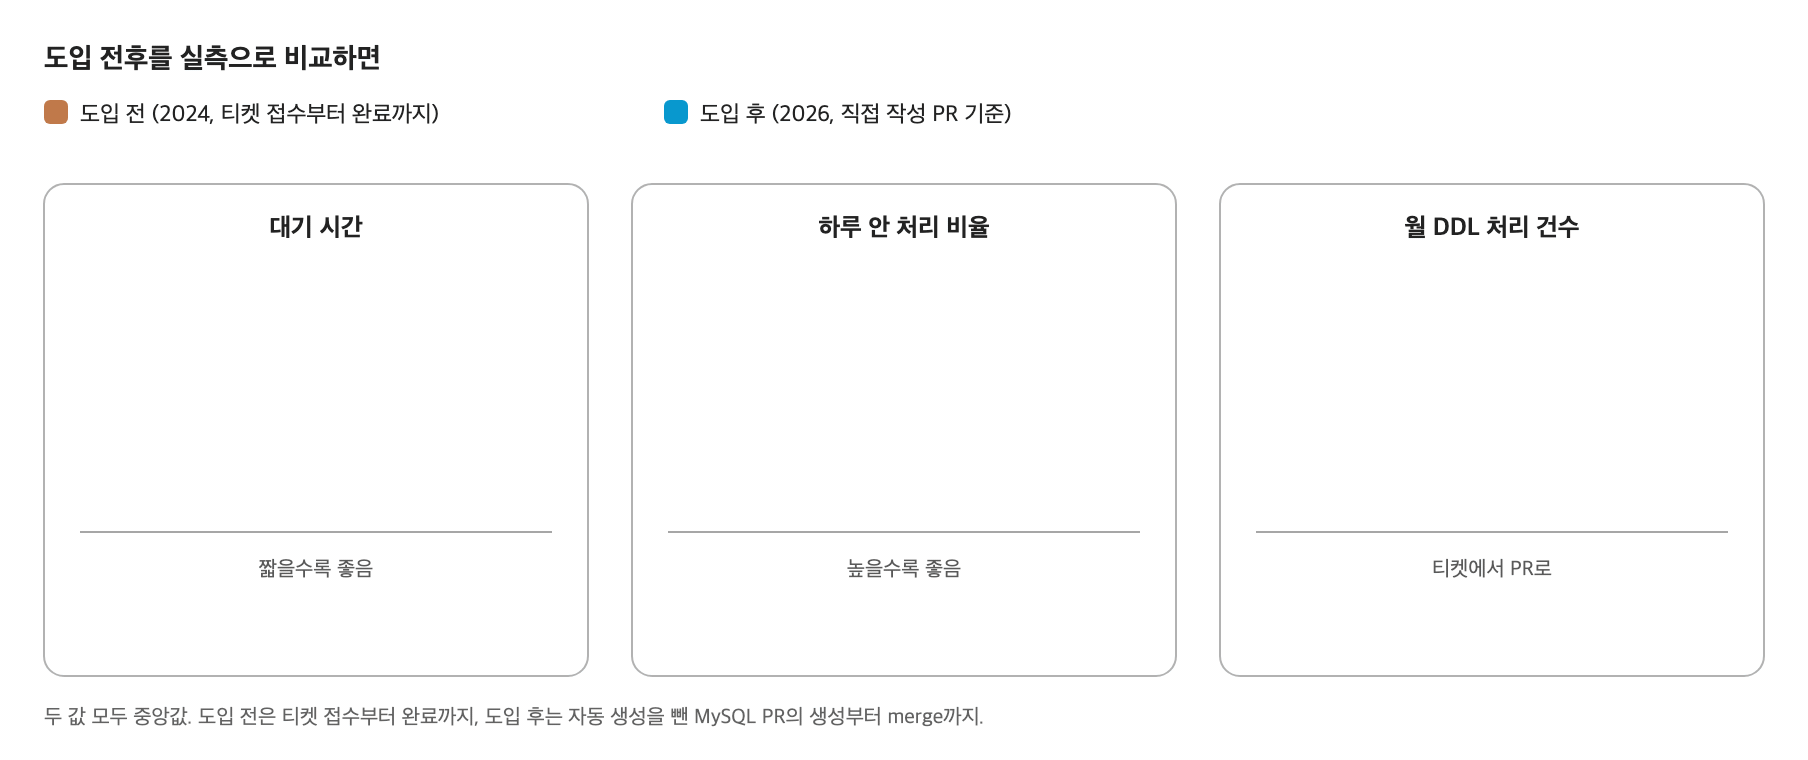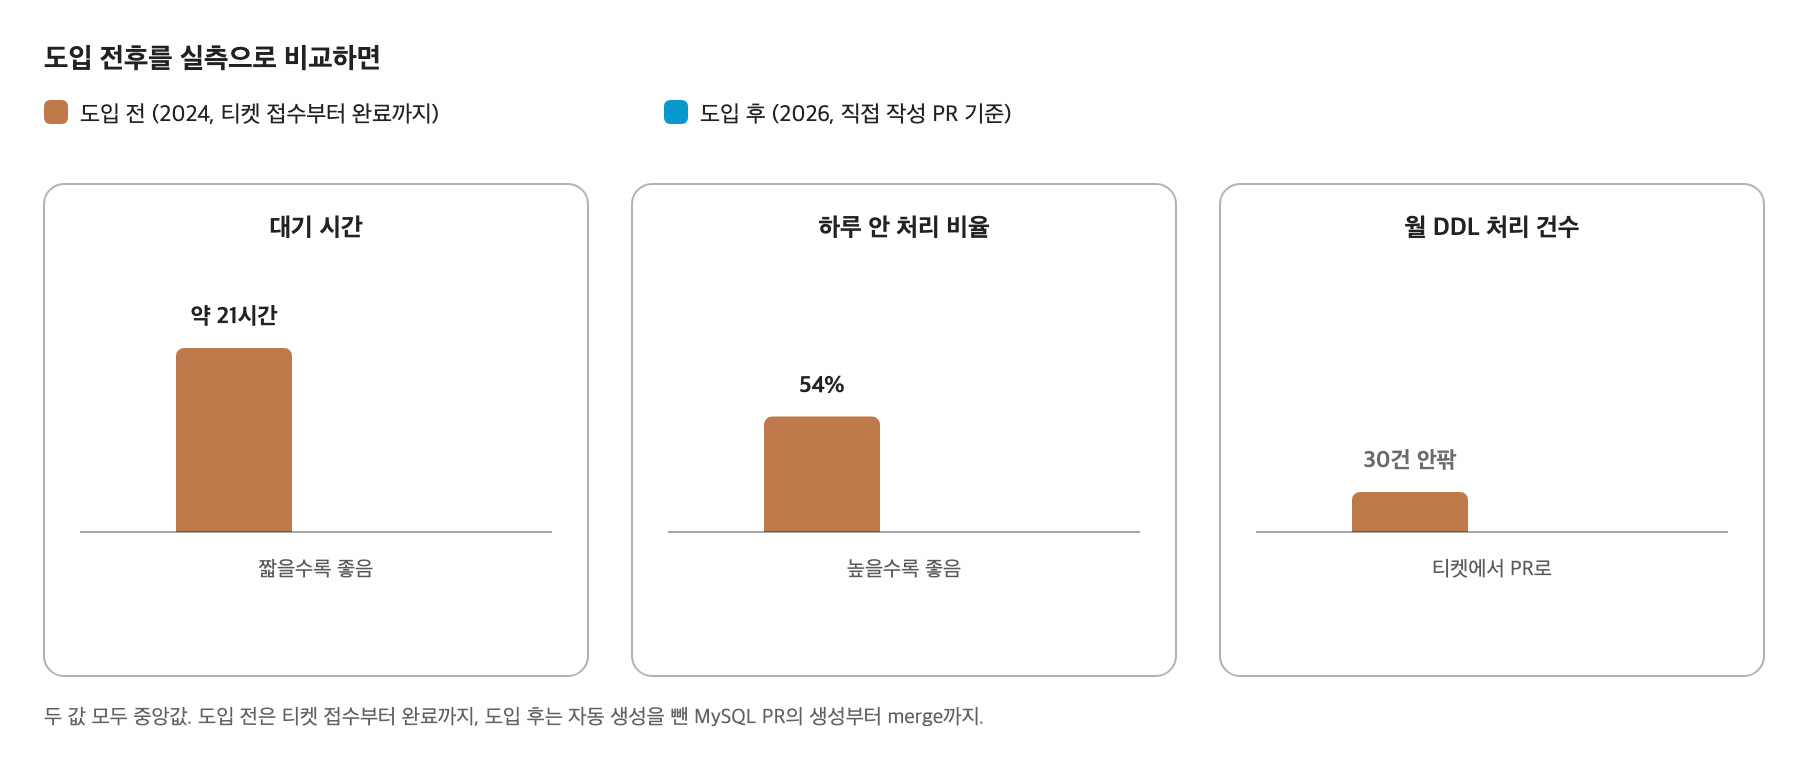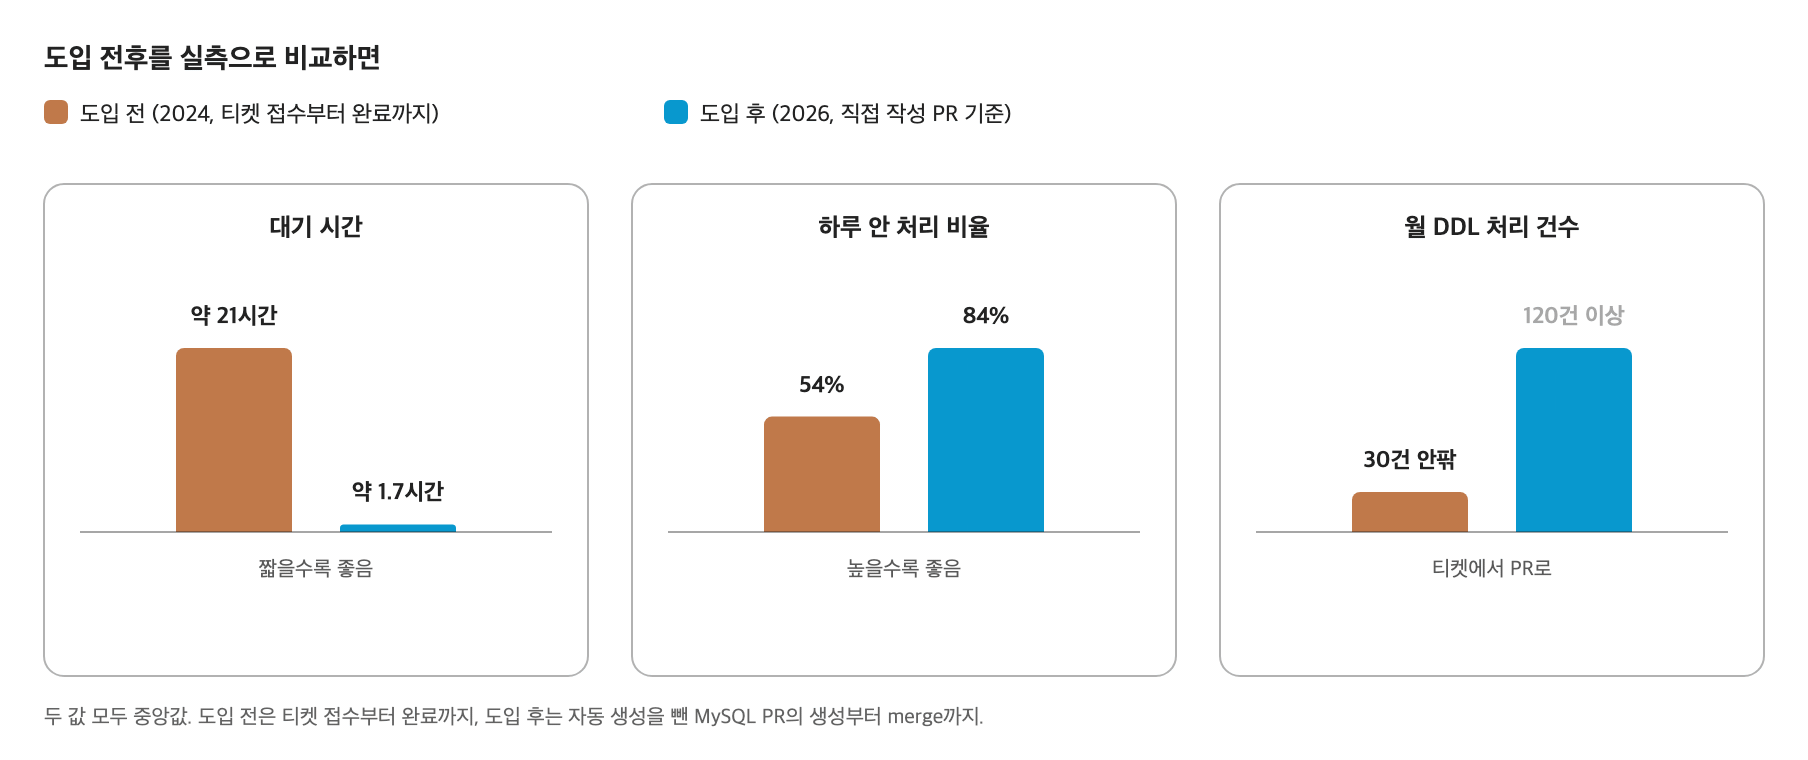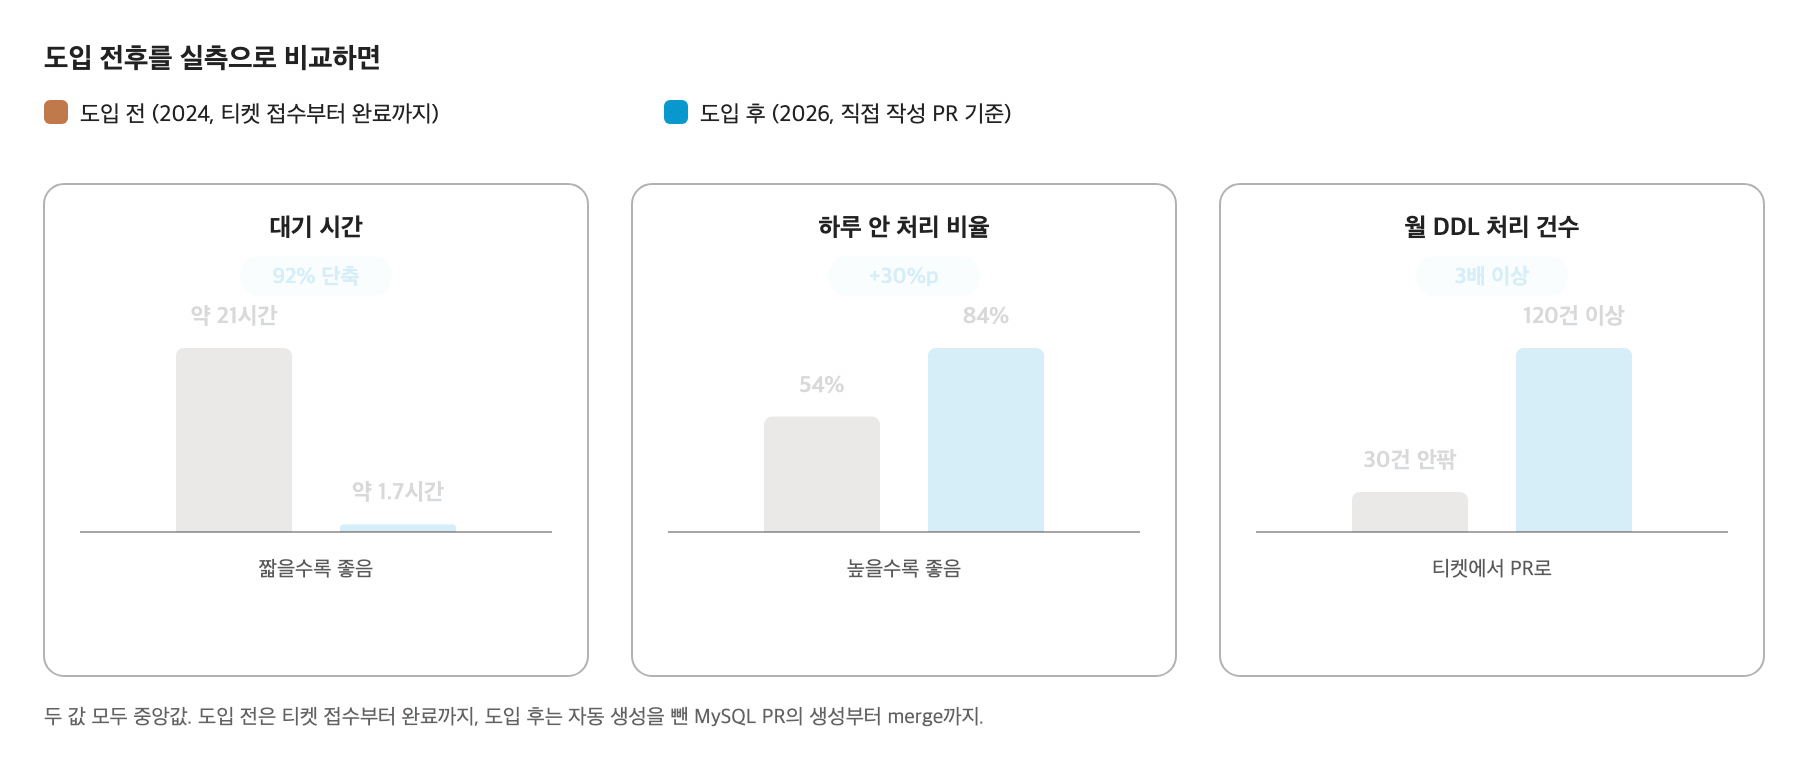
가장 큰 변화는 대기 시간입니다. 2024년 DDL 요청 티켓은 접수부터 DB 반영까지 약 21시간(중앙값 기준, 이하 같음)이 걸렸고, 하루 안에 끝난 요청은 54%로 절반을 조금 넘는 데 그쳤습니다. 지금 개발자가 직접 올리는 DDL PR은 생성부터 merge 후 DB 반영까지 약 1.7시간이면 되고, 하루 안에 merge되는 비율은 84%입니다.
dev 환경은 merge와 함께 반영까지 끝나고, qa와 prod는 코드 오너 승인을 거쳐 merge된 뒤 배포가 이어집니다. 적어도 개발 단계에서는, 요청 글을 쓰고 다음 날을 기다리던 일이 PR을 올리고 잠깐 다른 일을 하다 오면 끝나 있는 일이 됐습니다.
처리량의 변화도 뚜렷합니다. 매달 30건 안팎이던 DDL 작업이 2026년에는 MySQL DDL PR merge 건수 기준으로 월평균 120건을 넘었습니다. 도구가 자동으로 만들어 올리는 PR을 빼고 개발자가 직접 올린 것만 세어도 월평균 100건이 넘습니다. 이전의 3배가 넘는 변경량이 자동화된 파이프라인 위에서 더 짧은 대기 시간으로 소화되고 있습니다.
사람의 변화도 있습니다. 지금까지 저장소에는 2,000건이 넘는 PR이 merge됐고, commit을 남긴 사람은 100명에 가깝습니다. 이 가운데 대부분은 DBRE가 아니라 각 서비스의 개발자입니다. DB 변경이 더 이상 특정 팀의 전유물이 아니라는 가장 확실한 증거인 셈입니다.
DBRE가 일하는 방식도 달라졌습니다. 요청 경로를 안내하고 컨벤션을 교정하던 부담이 줄어든 만큼, 위험한 변경을 깊이 검토하고 플랫폼 자체를 개선하는 데 더 많은 시간을 쓰고 있습니다.
앞으로의 여정
팀이 세운 전제는 하나입니다.
사람이 손으로 하는 일의 많은 부분은 결국 자동화할 수 있다는 것. DDL 요청이 PR이 되고 반복 질문이 셀프서비스가 됐듯, 아직 사람 손에 남아 있는 작업들도 하나씩 자동화의 영역으로 옮겨 가고 있습니다.
돌아보면 팀에는 오래 쌓인 운영 경험과 시도해 보고 싶었던 아이디어가 늘 있었지만, 그것을 시스템으로 옮길 손이 부족했습니다. AI Native를 지향하는 회사의 흐름 속에서 DDL 리뷰처럼 특정 작업에 AI를 붙이자, 그 부족함이 채워지기 시작했습니다. 사고를 겪으며 쌓은 체크리스트를 리뷰 게이트로, 머릿속에만 있던 안전장치를 실제 파이프라인으로 만들어 내는 시간이 크게 줄었습니다.
이 과정에서 DBRE의 역할도 달라집니다. 단순 반복적이고 노동 집약적인 업무에서 벗어나, AI와 함께 더 어려운 문제를 풀고, 그 결과가 안전하게 동작하도록 가드레일을 세우는 일.
그것이 팀이 그리는 DBRE의 다음 모습입니다.
긴 글 읽어주셔서 감사합니다.